Dans la plupart des projets que nous auditons, le point de départ est le même : un dossier partagé, un assistant branché dessus, et la conviction que l'essentiel est fait. Quelques semaines plus tard, l'assistant répond avec la même assurance à une question sur la procédure en vigueur et à une question dont la réponse dort dans une version de 2019. Personne ne sait dire laquelle des deux il a consultée. Ce n'est pas un problème de modèle : c'est un problème de corpus. Une base de connaissance RAG entreprise n'est pas un raccordement technique, c'est une décision éditoriale sur ce que votre organisation sait réellement et sur ce qui mérite d'être interrogé.
Cet écart explique la majorité des déceptions constatées. La technologie de génération augmentée par récupération est disponible, documentée, accessible ; ce qui manque, c'est la discipline sur ce qu'on met dedans. Trois questions déterminent l'issue du projet : que met-on dans la base, qui la maintient dans le temps, et comment prouve-t-on qu'elle répond juste. Ce guide traite ces trois questions dans l'ordre, de la définition opérationnelle jusqu'au protocole d'évaluation et au coût d'entretien.
Ce que vous trouverez dans ce guide
- Distinguer une vraie base de connaissance d'un simple corpus branché sur un assistant, pour savoir ce que vous achetez.
- Comprendre pourquoi la majorité des projets échouent sur le contenu, et appliquer un filtre de tri reproductible.
- Trancher entre RAG, fine-tuning, moteur de recherche d'entreprise ou statu quo, sans se tromper de combat.
- Traiter la sécurité, les droits d'accès et le RGPD comme des contraintes d'architecture, pas comme des arguments.
- Construire un protocole d'évaluation qui prouve que le système répond juste, avant la mise en production.
- Déployer par un périmètre étroit, puis maintenir la base contre l'obsolescence silencieuse.
Ce qu'est réellement une base de connaissance RAG (et ce qu'elle n'est pas)
La définition circule partout et n'apporte plus de différenciation. Nous la posons donc rapidement, puis nous traçons la frontière que presque personne ne trace : celle qui sépare un corpus connecté d'une connaissance structurée. C'est dans cet interstice que se jouent les résultats.
La génération augmentée par récupération en une phrase opérationnelle
La génération augmentée par récupération consiste à faire consulter au modèle un corpus contrôlé au moment précis de la requête, puis à lui imposer de fonder sa réponse sur les extraits retrouvés. Le modèle ne puise pas dans ce qu'il a mémorisé lors de son entraînement : il lit, à l'instant de la question, les fragments que le système lui a remontés. La conséquence opérationnelle est directe et souvent sous-estimée : la connaissance devient modifiable sans toucher au modèle. Vous corrigez une procédure dans votre référentiel, et la réponse change dès la requête suivante. C'est ce découplage entre le modèle et la connaissance qui rend l'approche exploitable dans une entreprise dont les règles bougent plusieurs fois par an.
Connecter des documents n'est pas structurer une connaissance
Un assistant généraliste branché sur un dossier partagé et une base de connaissance RAG produisent tous deux des réponses fluides. Ils ne produisent pas la même fiabilité. Dans le premier cas, aucune hiérarchie entre les documents, aucun filtre sur ce qui entre, aucune notion de fraîcheur : tout ce qui existe concourt à égalité. Dans le second, une sélection explicite, un découpage pensé pour la récupération, des métadonnées qui portent la date, le propriétaire et le statut de chaque fragment, et des droits attachés au contenu lui-même.
Le mode d'échec typique n'est pas le silence, c'est l'assurance. Le système répond exactement sur le même ton qu'il ait retrouvé la procédure en vigueur ou une version périmée depuis quatre ans. Aucun signal ne distingue les deux situations pour l'utilisateur. C'est précisément ce qui rend le RAG sur documents internes dangereux lorsqu'il est monté sans discipline : l'erreur ne se voit pas, elle se propage.
Corpus connecté ou base structurée : la distinction qui décide du résultat
Un corpus connecté rend des documents interrogeables : tout ce qui existe est accessible, sans tri ni hiérarchie, et la fraîcheur n'est pas une information disponible pour le système.
Une base structurée rend une connaissance exploitable : chaque fragment porte une date, un propriétaire, un statut et des droits ; les contenus obsolètes ou redondants ont été écartés avant l'ingestion ; la récupération peut filtrer sur ces attributs.
Le premier coûte quelques jours de raccordement. La seconde coûte un travail documentaire réel — et c'est elle qui détermine si les équipes feront confiance aux réponses au bout de trois mois.
Les quatre briques du pipeline
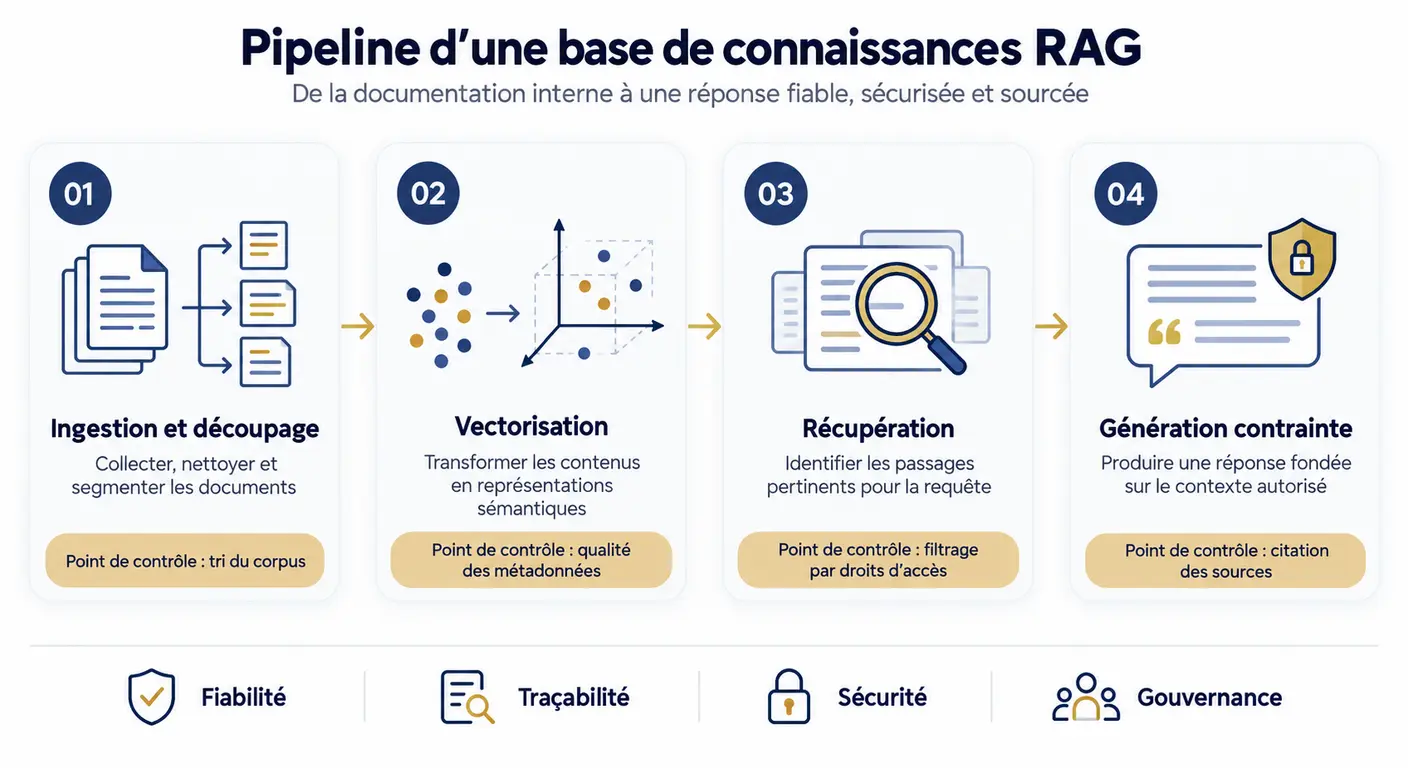
Le pipeline tient en quatre étapes, que la SERP décrit déjà abondamment. L'ingestion et le découpage transforment vos documents en fragments de taille cohérente avec la question posée. La vectorisation convertit ces fragments en représentations numériques permettant de les rapprocher d'une requête. La récupération sélectionne les fragments les plus proches de la question. La génération contrainte produit la réponse en s'appuyant exclusivement sur ces extraits, avec citation des sources.
La brique que les descriptions omettent presque systématiquement est la cinquième : le contrôle des droits appliqué au moment de la récupération, et non au moment de l'affichage. Filtrer après coup revient à laisser le modèle lire des contenus qu'un utilisateur n'aurait pas dû voir, puis à espérer qu'il n'en dise rien. Ce point conditionne l'architecture entière et se conçoit avant la première ligne de code, pas pendant la recette.
Pourquoi la plupart des bases de connaissance RAG échouent
C'est ici que se joue l'essentiel, et c'est ici que la documentation disponible est la plus pauvre. Les échecs observés ne relèvent presque jamais de la technique : ils relèvent d'une absence de décision sur le contenu.
Le réflexe du déversement documentaire
Le scénario se répète avec une régularité frappante. Le projet démarre, l'équipe demande « toutes les sources disponibles », et reçoit le site public, les brochures commerciales, les procédures internes, les comptes rendus, les archives, les anciennes versions. La logique implicite est que le volume produit la qualité : plus la base contient d'informations, plus elle saura répondre.
Le mécanisme d'échec est mécanique. Un contenu obsolète ou générique ne porte aucun signal qui le désigne comme tel au moment de la récupération. Il est évalué sur sa proximité sémantique avec la question, exactement comme le contenu juste, et il concourt à égalité. Une brochure de 2021 qui décrit un processus abandonné ressemble beaucoup, pour un système de recherche vectorielle, à la procédure en vigueur.
La conséquence est contre-intuitive et doit être dite clairement aux directions qui pilotent ces projets : le taux de réponses partiellement fausses augmente avec le volume ingéré, pas l'inverse. Ajouter du contenu non trié dégrade la performance au lieu de l'améliorer. C'est le seul endroit du projet où moins produit réellement mieux.
Trier ce qui distingue l'entreprise de ce qui est déjà su
Le tri se ramène à une question unique, que n'importe quel responsable métier peut appliquer seul sur son propre corpus : un modèle de langage saurait-il produire cette information sans aucun accès à notre entreprise ?
Cette question sépare trois niveaux. L'information banale est déjà connue de tous les modèles : la définition d'un contrat de prestation, le fonctionnement général d'un dispositif réglementaire public, les bonnes pratiques d'un métier. L'information contextuelle est utile mais non distinctive : votre organigramme, vos horaires, la liste de vos implantations. L'information distinctive est vérifiable, interne, introuvable ailleurs : vos barèmes réels, vos cas limites arbitrés, les raisons derrière vos procédures, les exceptions que vous accordez et celles que vous refusez.
La conséquence opérationnelle est franche. Les deux premiers niveaux gonflent le corpus et diluent la pertinence de la recherche sans rien apporter que le modèle ne sache déjà formuler. Le troisième niveau est le seul qui justifie économiquement le projet. Une base de trois cents pages réellement distinctives vaut mieux qu'une base de quinze mille pages où elles sont noyées. Quand vos équipes perdent du temps à chercher des informations, ce n'est presque jamais l'information banale qui leur manque.
La connaissance qui n'est écrite nulle part
Reste la part la plus précieuse et la moins accessible : la connaissance non documentée. Les arbitrages rendus au fil des années, les cas limites traités au téléphone, les raisons qui expliquent pourquoi une procédure est formulée ainsi et pas autrement. Cette connaissance vit chez trois ou quatre experts, et elle disparaît avec eux — départ, mobilité, retraite.
La méthode d'extraction est simple mais exigeante. Analysez d'abord le corpus existant pour identifier les zones de silence : les questions fréquentes auxquelles aucun document ne répond. Construisez à partir de là une liste de questions ciblées. Conduisez des entretiens courts avec les détenteurs de la connaissance, puis mettez en forme les réponses dans un format structuré et homogène avec le reste du corpus. Confrontez enfin ces contenus aux documents en place.
Le point de contrôle est non négociable : toute contradiction entre l'entretien et le document existant remonte à un arbitrage humain. Elle ne se résout pas automatiquement, et surtout pas en laissant les deux versions cohabiter dans la base en espérant que la récupération choisira bien.
Ce qu'il faut exclure du corpus dès le départ
Les contenus marketing et commerciaux publics
brochures, pages de site, plaquettes — le modèle sait déjà les produire et ils polluent la récupération
Les versions antérieures non marquées
toute procédure remplacée qui ne porte pas de statut explicite « obsolète » dans ses métadonnées
Les comptes rendus bruts non arbitrés
ils contiennent des positions discutées, pas des décisions, et le système les restitue comme des règles
Les documents sans propriétaire identifié
si personne n'est responsable de leur mise à jour, leur obsolescence est programmée dès l'ingestion
Les doublons partiels
deux versions proches d'un même document produisent des réponses instables selon celle qui remonte
Les contenus à droits flous
tout document dont vous ne savez pas dire qui a le droit de le lire doit rester hors du corpus jusqu'à clarification
Un audit de faisabilité RAG sur corpus documentaire métier commence précisément par ce travail d'exclusion. C'est moins spectaculaire que le choix d'un modèle, et infiniment plus déterminant.
RAG, fine-tuning ou recherche d'entreprise : comment trancher
La comparaison entre RAG et fine-tuning est devenue un passage obligé, souvent traitée comme un duel technique. Elle ignore deux options qui restent parfaitement rationnelles pour un décideur. Nous les remettons dans le tableau, parce qu'une recommandation n'est crédible que si elle assume les cas où elle ne s'applique pas.
Quatre options, quatre problèmes différents
Le RAG répond à un besoin de connaissance changeante, traçable et cloisonnée par droits. Il est pertinent quand la réponse doit citer sa source, évoluer sans redéploiement, et varier selon qui pose la question.
Le fine-tuning répond à un besoin de comportement : ton, format de sortie, respect d'une structure de réponse, vocabulaire métier. Il n'apporte aucune fraîcheur de connaissance et ne permet aucune citation de source. Un modèle affiné reste figé sur ce qu'on lui a appris.
Le moteur de recherche d'entreprise reste supérieur dans un cas précis et fréquent : l'utilisateur sait ce qu'il cherche et veut le document lui-même, pas une synthèse. Un juriste qui cherche un contrat signé ne veut pas un résumé de ce contrat.
Ne rien faire reste rationnel quand le corpus n'existe pas sous une forme exploitable. Si la connaissance est dispersée dans des boîtes mail et des têtes, le chantier préalable est documentaire, pas technologique.
Les critères d'arbitrage qui comptent vraiment
Cinq critères suffisent à trancher : la fréquence de mise à jour de la connaissance, le besoin de citation des sources, la sensibilité des données, le nombre d'utilisateurs concernés, et le coût d'une réponse fausse.
Le dernier mérite qu'on s'y arrête, car il est presque toujours traité en dernier alors qu'il devrait être traité en premier. Le coût d'une réponse fausse détermine le niveau d'exigence du protocole d'évaluation, donc le budget du projet. Un assistant qui se trompe sur le solde de congés génère un agacement. Un assistant qui se trompe sur un protocole réglementé génère un risque juridique. Ces deux systèmes ne demandent ni le même effort de recette, ni le même dispositif de contrôle, ni la même enveloppe. Poser ce critère au démarrage évite les mauvaises surprises en comité d'investissement.
| Critère | RAG documentaire | Fine-tuning | Recherche d'entreprise | Statu quo outillé |
|---|---|---|---|---|
| Ce que ça modifie | La connaissance consultée | Le comportement du modèle | L'accès aux documents | Rien, sinon l'organisation |
| Fraîcheur des données | Immédiate, sans redéploiement | Figée à l'entraînement | Immédiate | Dépend des équipes |
| Traçabilité des réponses | Sources citées par construction | Aucune | Le document lui-même | Humaine |
| Coût d'exploitation | Entretien documentaire récurrent | Ré-entraînements périodiques | Licence et indexation | Temps des experts |
| Risque principal | Obsolescence silencieuse du corpus | Erreur d'arbitrage initiale | Faible adoption | Perte de connaissance |
Comparatif des quatre options face à un problème d'accès à la connaissance interne
Le cas fréquent de la combinaison
En production, les deux approches se combinent souvent : un modèle affiné pour respecter un format de réponse strict, alimenté par une récupération documentaire pour la fraîcheur. Cette combinaison est légitime, mais elle arrive après, pas avant.
L'erreur d'arbitrage la plus coûteuse que nous observons est l'inverse : engager un fine-tuning alors que le problème exprimé est un problème de fraîcheur documentaire. Le projet consomme plusieurs mois et un budget significatif pour produire un modèle qui parle bien et se trompe sur les faits. Si la question posée par vos équipes est « où en est la procédure actuelle », RAG ou fine-tuning n'est pas un vrai dilemme : la réponse est la récupération.
Sécurité, droits d'accès et conformité : les contraintes qui se conçoivent en amont
La conformité est presque toujours présentée comme un argument de vente. Elle est d'abord une contrainte de conception, qui détermine des choix difficilement réversibles une fois l'architecture posée.
L'héritage des permissions, non négociable
Le risque central est simple à formuler et rarement anticipé : un système qui ignore les droits documentaires devient un canal d'accès à des informations auxquelles l'utilisateur n'aurait jamais accédé autrement. Il ne s'agit pas d'une faille exotique. Il s'agit du comportement par défaut d'un pipeline monté sans filtrage, où l'ensemble du corpus est interrogeable par tous ceux qui ont accès à l'interface.
Le principe de mise en œuvre est l'héritage des permissions : chaque fragment porte, dans ses métadonnées, les droits du document dont il est issu ; la récupération filtre les résultats à partir de l'identité de l'utilisateur avant que le modèle ne voie quoi que ce soit. Le filtrage se fait à la récupération, jamais à l'affichage.
La conséquence projet est lourde et mérite d'être annoncée dès le cadrage : les droits doivent être propres dans les systèmes sources avant l'ingestion. Dans la majorité des organisations, ils ne le sont pas. Dossiers ouverts par commodité, partages hérités d'un projet clos, permissions jamais révisées. Le projet déclenche alors un chantier préalable de remise au propre que personne n'avait budgété, et qui devient le vrai chemin critique.
Le risque de fuite par requête en langage naturel
Une interface conversationnelle ne se protège pas comme un référentiel documentaire. Un utilisateur n'a pas besoin de savoir qu'un document existe pour en obtenir le contenu : il lui suffit de poser la bonne question en langage naturel. « Quelle est la grille salariale des chefs de projet ? » n'a pas la forme d'une tentative d'accès non autorisé, mais c'en est une si le filtrage par droits n'est pas appliqué à la récupération.
Ce risque est aggravé par la synthèse : le système peut recomposer, à partir de plusieurs fragments individuellement anodins, une information que personne n'avait le droit de reconstituer. Le contrôle d'accès doit donc porter sur les fragments récupérés, en amont de la génération, et les requêtes doivent être journalisées au même titre que les accès documentaires classiques.
RGPD et minimisation appliquée à un pipeline documentaire
Deux obligations se traduisent directement en choix d'architecture. La première est la minimisation : ne récupérer que ce qui est nécessaire à la production de la réponse, ce qui plaide pour un découpage fin et un nombre de fragments remontés volontairement limité. La seconde est le reflet des habilitations existantes : le système ne doit créer aucun droit nouveau, il applique ceux qui existent déjà.
Un point technique reste peu connu des directions qui valident ces projets : une base vectorielle non chiffrée demeure un actif sensible. Les représentations numériques ne sont pas une forme d'anonymisation. Elles conservent une part substantielle de l'information source, et des travaux publiés montrent qu'un texte peut être partiellement reconstruit à partir de ses vecteurs. Une base vectorielle contenant des données personnelles se traite donc comme un traitement de données personnelles à part entière, avec chiffrement, contrôle d'accès et durée de conservation définie. Les enjeux de protection des données IA en entreprise se posent ici avec la même rigueur que sur n'importe quel système métier.
Souveraineté et niveaux de déploiement
Trois options de déploiement existent, et leur coût réel ne se lit pas seulement en euros. L'hébergement interne sur l'infrastructure de l'entreprise supprime toute transmission à un tiers, mais exige des compétences d'exploitation, de supervision et de mise à jour que peu de PME possèdent en interne. Le cloud européen réduit la charge d'exploitation tout en maintenant la localisation des traitements, au prix d'une dépendance contractuelle. Le service géré minimise l'effort interne et maximise la dépendance, avec un contrôle réduit sur les évolutions.
Le choix se fait sur deux axes : la sensibilité effective des données traitées et les compétences réellement disponibles. Une base de connaissance RAG entreprise hébergée en France sur une infrastructure que personne ne sait exploiter n'est pas plus sûre qu'un service géré correctement contractualisé.
S'ajoute une exigence de transparence applicable aux systèmes conversationnels : l'utilisateur doit savoir qu'il s'adresse à un système automatisé. La citation systématique des sources sert ici un double objectif, d'usage et d'auditabilité : elle permet à l'utilisateur de vérifier, et à l'auditeur de reconstituer le raisonnement. Un mot de prudence pour finir : le RAG facilite la traçabilité, il ne produit pas la conformité. Aucune architecture ne dispense d'une analyse d'impact quand elle est requise, et les questions de gouvernance de l'IA en entreprise restent entières.
Prouver que la base de connaissance répond juste
C'est le gap le plus net de la documentation disponible : presque personne ne propose de protocole d'évaluation. C'est pourtant la seule chose qui distingue un démonstrateur séduisant d'un système qu'on met entre les mains de cinquante personnes.
Constituer un jeu de questions réelles avant de démarrer
Recueillez 50 à 100 questions réellement posées par les équipes. Pas des questions imaginées en atelier : des questions tirées des tickets, des fils de discussion internes, des sollicitations adressées aux experts. Pour chacune, notez la réponse attendue et le document source qui fait référence.
Ce jeu se construit avant le développement, et cette antériorité n'est pas un détail de méthode. Il joue deux rôles simultanés : il constitue un cahier des charges implicite, en révélant ce que le système devra savoir traiter ; et il fournit la recette de fin de projet, sur laquelle la mise en production sera prononcée ou refusée. Constitué après coup, il sera inconsciemment ajusté aux capacités du système livré, et ne prouvera plus rien.
Les quatre choses à mesurer
Quatre mesures suffisent, et elles doivent être distinguées car elles échouent indépendamment.
La récupération a-t-elle remonté le bon document ? C'est l'indicateur le plus prédictif de la qualité finale : si le bon fragment n'est pas remonté, aucune qualité de génération ne sauvera la réponse. C'est aussi l'indicateur le plus facile à mesurer, puisque vous connaissez le document de référence.
La réponse est-elle fondée sur les extraits fournis, sans ajout ? Le modèle peut compléter avec ses connaissances générales, produisant une réponse plausible mais non fondée sur votre corpus.
Les sources citées correspondent-elles à la réponse ? Une citation qui ne soutient pas l'affirmation qu'elle accompagne détruit la confiance plus sûrement qu'une absence de citation.
Le système reconnaît-il son ignorance quand la réponse n'est pas dans le corpus ? Ce point est le plus souvent négligé et le plus coûteux en confiance utilisateur. Un système qui répond toujours, y compris quand il ne sait pas, est un système qu'on cesse d'utiliser dès la première erreur découverte. Un système qui dit « je n'ai pas cette information dans les documents disponibles » reste utilisable même imparfait.
- 19 %part du temps de travail des collaborateurs consacrée à la recherche et à la collecte d'informations internes (McKinsey Global Institute, 2012)
- 80 %part estimée des données d'entreprise existant sous forme non structurée, donc non interrogeable par les outils décisionnels classiques (Gartner)
- 4 lignes budgétairesaudit, préparation du corpus, infrastructure, entretien récurrent — la dernière étant la plus souvent omise des business cases
McKinsey Global Institute, The social economy (2012) ; Gartner, prévisions marché de la donnée non structurée
Définir un seuil d'acceptation avant la mise en production
Le seuil d'acceptation n'est pas une valeur universelle : il dépend du coût d'une réponse fausse dans le processus concerné. Un assistant sur les procédures de congés peut vivre avec un taux d'erreur que n'accepterait jamais un assistant sur des protocoles réglementés. Le premier produit un agacement rattrapable, le second un risque documenté.
La règle tient en une phrase, et elle mérite d'être écrite dans le cahier de recette : sans seuil d'acceptation défini avant la recette, le projet est déclaré réussi par défaut. Personne n'arrête un système qui fonctionne « globalement bien » en l'absence de critère. C'est aussi ce qui rend la mesure du retour sur investissement de l'IA démontrable en comité : un seuil écrit transforme une impression en décision.
Déployer et maintenir : de l'audit de faisabilité à l'autonomie des équipes
Les phases projet décrites ailleurs sont génériques et interchangeables. Ce qui manque presque partout, c'est le coût d'entretien et le mode d'échec silencieux de la maintenance. Ce sont pourtant les deux sujets qui décident de la survie du système au-delà de six mois.
Commencer par un audit de faisabilité, pas par un outil
Un audit de faisabilité produit trois livrables, et aucun n'est un choix d'outil. Le premier est la cartographie des sources et de leur fraîcheur : où vit la connaissance, qui la met à jour, à quelle fréquence, et sous quel format. Le deuxième est l'identification du cas d'usage prioritaire : quelle question, posée par qui, coûte le plus cher aujourd'hui. Le troisième est la mesure de la situation de départ : temps passé à chercher, volume de sollicitations adressées aux experts, taux d'erreur documentaire constaté.
Cette dernière mesure conditionne tout le reste. Sans point de départ chiffré, aucun avant/après n'est démontrable ; sans avant/après, aucun budget n'est reconductible en année deux. La démarche d'audit IA en entreprise a exactement cette fonction : transformer une intuition en périmètre mesurable avant d'engager la dépense.
Un périmètre restreint, un métier, un propriétaire
Le premier périmètre doit être volontairement étroit : un processus, un groupe d'utilisateurs identifié, un corpus maîtrisé. Cette restriction n'est pas de la prudence excessive, c'est ce qui rend l'évaluation possible et l'échec peu coûteux.
Le facteur d'adoption principal n'est ni la qualité du modèle ni l'ergonomie de l'interface : c'est l'intégration dans l'outil déjà utilisé par les équipes. Un assistant accessible depuis la messagerie interne ou l'outil métier est consulté ; le même assistant derrière une nouvelle URL à mémoriser ne l'est pas.
Cela répond frontalement à l'objection la plus fréquente en comité, celle du dirigeant opérationnel qui a déjà vu un outil IA échouer : l'absence d'adhésion vient presque toujours de deux causes identifiables, un outil ajouté à côté du flux de travail plutôt que dedans, et l'absence d'un propriétaire métier responsable du contenu. Pas d'un problème de technologie. Sur ce point, la conduite du changement lors d'un projet IA pèse davantage que l'architecture retenue, et les travaux sur le RAG et la productivité des équipes convergent : l'usage se gagne dans le flux existant, y compris quand la base alimente le RAG et le support client ou s'inscrit dans une intégration au SI plus large.
L'obsolescence silencieuse et son coût
Voici le mécanisme le moins anticipé de tous. Une base de connaissance non entretenue ne tombe pas en panne. Aucune alerte, aucune interruption de service, aucun ticket. Elle devient progressivement fausse tout en restant fluide, rapide et assurée. Les utilisateurs continuent de l'interroger et de lui faire confiance pendant des mois, jusqu'à ce qu'une erreur visible révèle que la dérive durait depuis longtemps.
Trois mécanismes de maintien limitent cette dérive. La détection des contradictions entre une information nouvellement ingérée et le référentiel existant, qui déclenche une revue humaine plutôt qu'une cohabitation silencieuse. La revue périodique des documents les plus cités, en partant du principe que le contenu le plus mobilisé mérite la vérification la plus fréquente. L'analyse des questions restées sans réponse, qui constitue le meilleur signal de lacune documentaire disponible — chaque question sans réponse désigne un contenu à produire ou à intégrer.
L'effort d'entretien se chiffre en temps humain récurrent, pas en licence. Comptez un référent métier disposant d'un créneau régulier pour arbitrer les contradictions et valider les mises à jour. C'est la ligne budgétaire que les business cases oublient systématiquement, et c'est celle dont l'absence tue le système en silence. Mettre en place un RAG sur la documentation interne d'une PME sans nommer ce référent revient à programmer l'obsolescence dès la mise en production.
Les cinq étapes d'un déploiement RAG maîtrisé
Audit de faisabilité
cartographie des sources, cas d'usage prioritaire, mesure chiffrée de la situation de départ
Tri et préparation du corpus
application du filtre de distinctivité, exclusion des contenus banals ou obsolètes, remise au propre des droits dans les systèmes sources
Jeu de questions et seuil d'acceptation
50 à 100 questions réelles avec réponse attendue et source de référence, seuil écrit avant tout développement
Périmètre pilote intégré
un processus, un groupe d'utilisateurs, une intégration dans l'outil déjà utilisé, un propriétaire métier nommé
Recette puis routine d'entretien
mesure des quatre indicateurs, décision franche d'industrialiser ou d'ajuster, créneau récurrent de revue documentaire
Rendre les équipes autonomes
La logique de tout ce qui précède mène à un point simple : un système que vous ne savez pas entretenir n'est pas un actif, c'est une dépendance. Le transfert de compétences appartient donc au périmètre du projet, pas à une option de fin de mission. Concrètement, cela signifie former le référent métier au tri du corpus, documenter la routine de revue et laisser l'entreprise conduire seule un cycle d'entretien complet avant la fin de l'accompagnement. La réussite se mesure au moment où l'organisation maintient sa base sans son prestataire.
Ce qu'une base de connaissance RAG ne réglera pas
Quatre limites méritent d'être posées avant toute décision d'investissement. Elles ne disqualifient pas l'approche ; elles délimitent ce qu'on peut raisonnablement en attendre.
Le RAG réduit les réponses inventées, il ne les supprime pas. Le modèle reste capable d'extrapoler autour des extraits fournis, de combler une lacune par une formulation plausible, ou de généraliser un cas particulier. La citation des sources rend ces écarts détectables, elle ne les empêche pas.
La fenêtre de contexte reste une contrainte. Un découpage inadapté au type de document dégrade mécaniquement la qualité des réponses, quelle que soit la puissance du modèle employé. Un tableau coupé en deux, une procédure séparée de sa condition d'application, et la récupération remonte un fragment techniquement pertinent mais inexploitable.
Une organisation qui ne sait pas où est sa source de vérité ne le découvrira pas grâce au RAG. Si trois référentiels concurrents coexistent, le système en choisira un sans vous dire pourquoi. La désignation de la source faisant autorité est une décision d'organisation, elle précède le projet technique.
Un désaccord interne sur une procédure reste un désaccord interne. Le système le rend visible, parfois brutalement, en restituant des réponses instables selon la formulation de la question. Il ne l'arbitre pas et n'a pas vocation à le faire.
“Une base de connaissance mal entretenue ne tombe jamais en panne. Elle devient fausse lentement, en gardant exactement le même ton assuré — et c'est précisément pour cela qu'on s'en aperçoit trop tard.”
Conclusion : la valeur tient à ce que vous seuls savez
Trois questions ouvraient ce guide. Elles se referment en trois phrases. Ce qu'on met dedans : uniquement l'information distinctive, celle qu'aucun modèle ne saurait produire sans accès à votre entreprise, y compris la connaissance non écrite extraite de vos experts. Qui le maintient : un propriétaire métier nommé, disposant d'un créneau récurrent pour arbitrer les contradictions, le coût d'entretien étant une ligne budgétaire et non une variable d'ajustement. Comment on le prouve : par un jeu de questions réelles constitué avant le développement et un seuil d'acceptation écrit avant la recette.
Ces trois réponses convergent vers une seule idée. La valeur d'une base de connaissance RAG est proportionnelle à la part d'expertise réellement distinctive qu'elle contient — et cette part se qualifie avant tout projet technique, par un travail documentaire que ni le choix du modèle ni celui de l'infrastructure ne remplaceront. Une entreprise qui fait ce tri obtient un système utile même modeste ; une entreprise qui l'évite obtient un démonstrateur convaincant qui perd la confiance de ses utilisateurs en un trimestre.
C'est la raison pour laquelle, chez Centauri, chaque projet de ce type commence par un audit de faisabilité sur le corpus et se termine par des métriques avant/après documentées.