Une plateforme visuelle, trois connecteurs, un modèle de langage branché au bout : la démonstration dure huit minutes et emporte l'adhésion d'un comité de direction. Six mois plus tard, dans la majorité des organisations que nous croisons, le flux existe toujours mais personne ne sait dire ce qu'il a fait gagner, ni qui en est responsable. Le décalage n'est pas entre la promesse et la technique, il est entre la facilité de construire et la difficulté de tenir. C'est précisément ce que recouvre aujourd'hui la question de l'IA sans développeur PME.
Cet article suit une logique de décision plutôt qu'une logique de catalogue. Vous y trouverez ce que la notion recouvre réellement, ce qu'elle permet et ce qu'elle ne permet pas, cinq usages dont le gain se mesure, un panorama des plateformes organisé par fonction, le coût complet sur vingt-quatre mois, le cadre de conformité à poser avant de brancher quoi que ce soit, puis une méthode de déploiement en quatre-vingt-dix jours. Chaque section se termine par une décision que vous pouvez prendre, pas par une intention.
Ce que recouvre vraiment l'IA no-code en entreprise
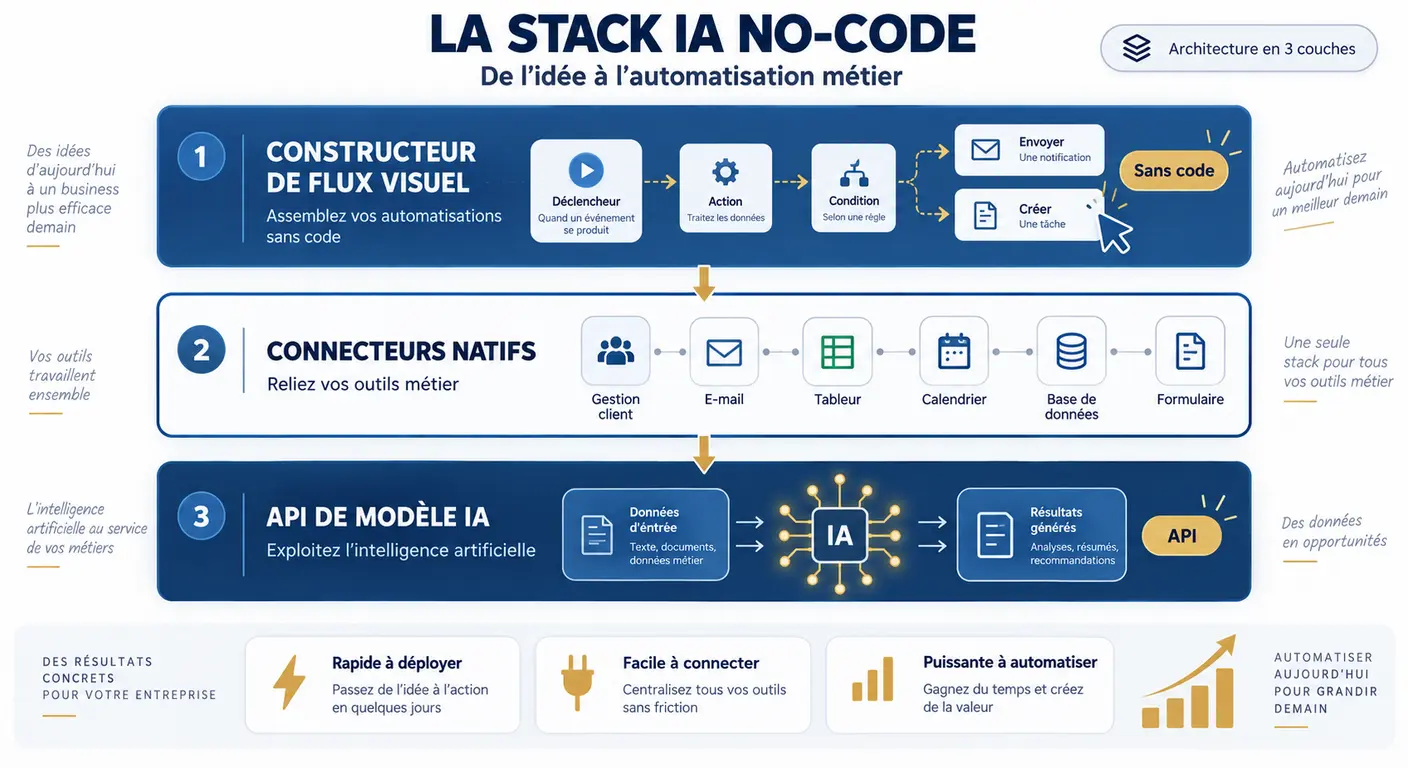
Définir l'intelligence artificielle no-code entreprise par ce qu'elle supprime — le code — conduit à une impasse analytique. Mieux vaut la définir par ce qu'elle assemble. Trois briques, empilées, forment toute solution de ce type. Au sommet, une interface visuelle de construction de flux, où vous enchaînez des étapes sous forme de blocs reliés entre eux. Au milieu, des connecteurs préconstruits vers les logiciels déjà en place chez vous : messagerie, espace de stockage, outil de gestion de la relation client, logiciel comptable. À la base, un appel à un modèle d'intelligence artificielle, via une interface de programmation, pour la seule partie que la logique conditionnelle ne sait pas traiter : l'interprétation.
Cette distinction a une conséquence directe sur votre lecture du marché. Le no-code n'a pas rendu l'intelligence artificielle accessible. Ce qui l'a rendue accessible, c'est la mise à disposition des modèles par interface de programmation, facturée à l'usage, sans engagement et sans infrastructure. Le no-code a fourni la tuyauterie qui permet de brancher cette capacité sur vos processus existants. Confondre les deux conduit à surestimer la plateforme et à sous-estimer ce qui se passe en dessous.
Trois objets sont par ailleurs régulièrement confondus dans les discussions de direction, alors qu'ils n'engagent ni les mêmes compétences ni les mêmes risques. L'automatisation de flux enchaîne des actions entre logiciels, sans interface pour l'utilisateur final. L'application métier construite visuellement produit un outil que vos équipes ouvrent et manipulent, avec une base de données derrière. L'assistant conversationnel répond à des questions en langage naturel, en s'appuyant ou non sur vos documents. Un projet qui mélange les trois sans le dire est un projet dont personne ne saura évaluer l'avancement.
| Critère | Développement dédié | No-code | Low-code |
|---|---|---|---|
| Compétence requise | Développeur confirmé | Référent métier formé | Profil technique partiel |
| Profondeur de personnalisation | Totale | Limitée au périmètre de l'outil | Étendue via scripts |
| Propriété du résultat | Code source détenu | Logique hébergée chez l'éditeur | Mixte |
| Coût de sortie | Faible, code réutilisable | Élevé si la logique n'est pas documentée | Moyen |
Trois régimes de construction comparés sur quatre critères de décision
No-code, low-code et développement : trois régimes, pas trois camps
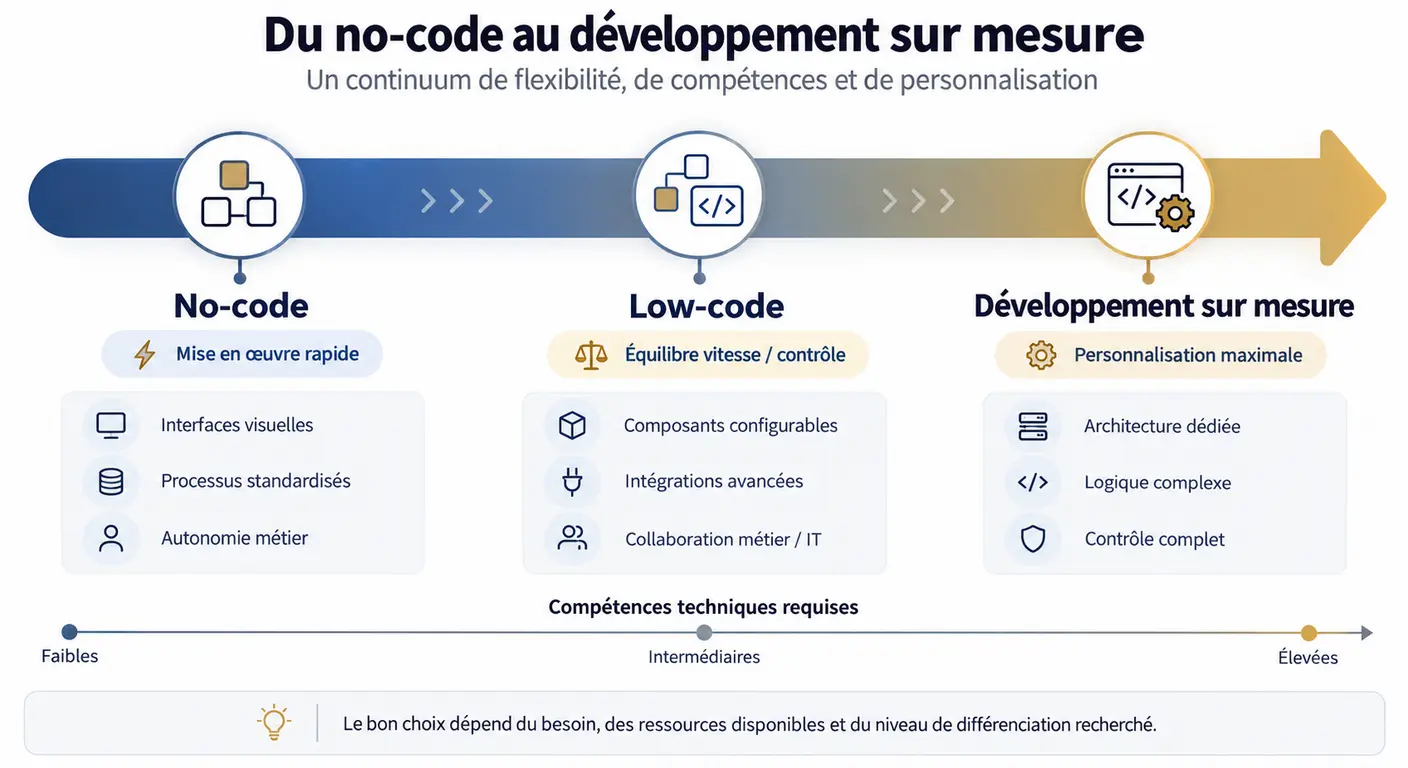
Présenter ces trois approches comme des camps rivaux est une erreur d'analyse répandue. Il s'agit d'un continuum, gradué par la compétence requise, et aucune organisation n'y reste durablement immobile. Le scénario le plus fréquent est même l'inverse d'un choix définitif : un flux no-code qui réussit attire de nouveaux cas, gagne des branches conditionnelles, devient critique, et finit partiellement réécrit dans un langage de programmation. Ce glissement n'est pas un échec de la démarche initiale, c'est son aboutissement normal.
La question utile n'est donc pas « faut-il faire du no-code ou du développement ? » mais « à quel endroit du continuum ce processus se trouve-t-il aujourd'hui, et qu'est-ce qui le ferait bouger ? ». Une PME peut parfaitement héberger trois flux no-code, une application low-code et un module développé sur mesure. Ce qui compte est de savoir pourquoi chacun est là.
Pourquoi l'IA a changé ce que le no-code sait faire
Avant l'arrivée des modèles de langage, un flux visuel ne savait traiter que des données déjà structurées. Il déplaçait une ligne d'un tableur vers un autre, créait une fiche à partir d'un formulaire, envoyait une notification selon une condition. Utile, mais confiné à ce qui était déjà rangé. Toute la matière non structurée de l'entreprise — les courriels, les pièces jointes, les comptes rendus, les réclamations — restait hors d'atteinte.
C'est là, et seulement là, que la rupture s'est produite. Un flux peut désormais lire un courriel et en extraire l'intention, récupérer les champs d'une facture photographiée de travers, classer une réclamation dans la bonne catégorie, résumer un échange de vingt messages. Automatiser avec l'IA sans coder signifie très exactement cela : brancher une capacité d'interprétation au milieu d'une chaîne d'actions déterministes. Nommer la rupture avec cette précision évite deux erreurs symétriques, celle qui consiste à croire que tout devient automatisable, et celle qui consiste à croire que rien n'a changé.
Conseil du coach
Tout ce qui relève de l'interprétation d'un document ou d'un message est devenu automatisable. Tout ce qui relève d'une décision engageante ne l'est pas.
Le rôle du référent interne, même sans profil technique
L'IA accessible sans compétence technique ne signifie pas l'IA sans personne responsable. Il existe une fonction, distincte d'un poste, sans laquelle aucun déploiement ne tient : quelqu'un qui connaît le processus de l'intérieur, sait le décrire sous forme de règles explicites, et accepte d'être identifié comme propriétaire des flux construits.
Cette personne n'a pas besoin de savoir programmer. Elle a besoin de trois choses : du temps alloué, pas seulement toléré ; un accès aux outils concernés ; et un mandat clair pour arbitrer les exceptions. Sans ce rôle nommé, ce que nous observons est toujours le même scénario : les flux fonctionnent, puis un connecteur change, une règle métier évolue, personne ne s'en aperçoit, et l'ensemble devient orphelin en l'espace d'un trimestre.
Conseil du coach
Le no-code ne supprime pas la complexité technique, il la déplace. Ce que vous ne codez pas, vous devrez le cartographier, le documenter et le maintenir.
Ce que l'IA no-code sait faire, et ce qu'elle ne sait pas faire
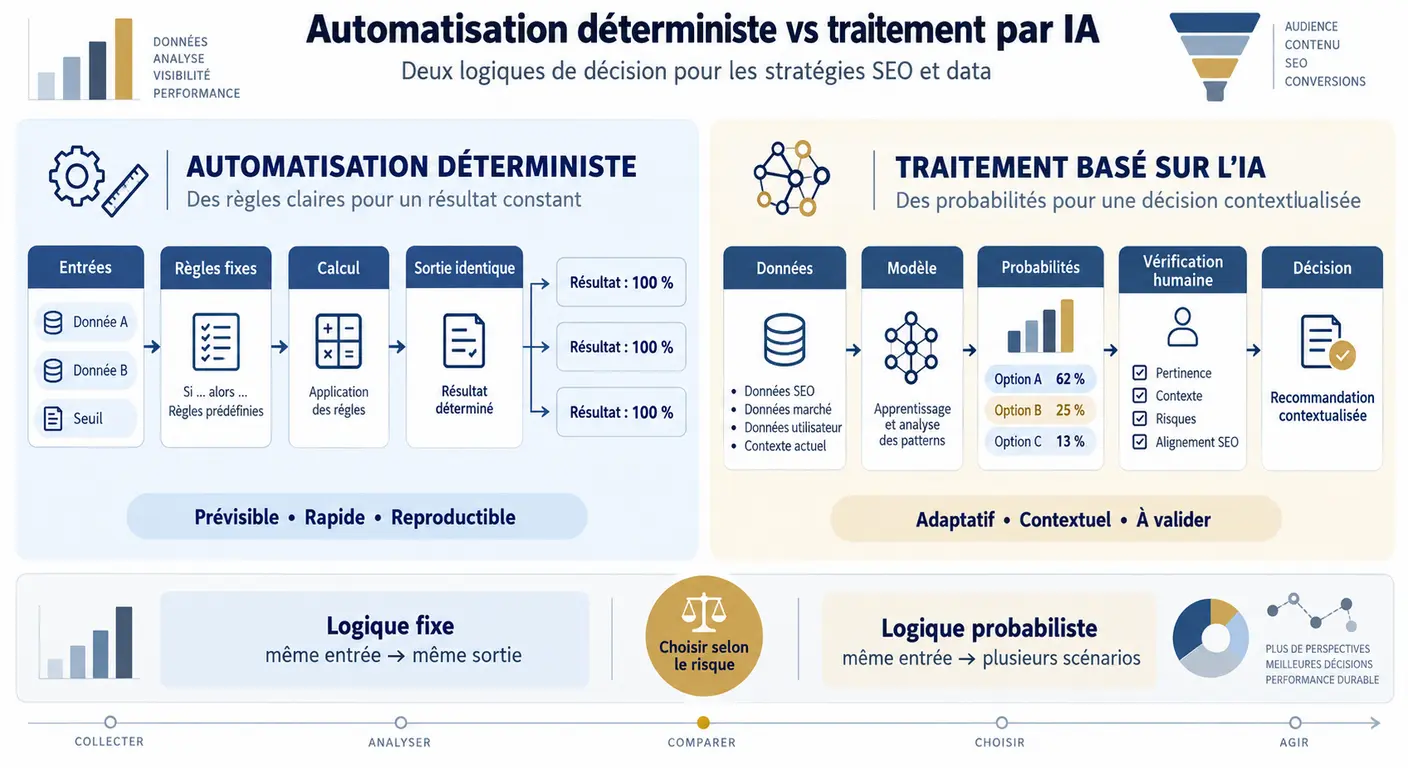
C'est ici que se joue la qualité d'une démarche d'automatisation IA sans programmation, et c'est ici que la plupart des contenus disponibles s'arrêtent. Il existe une différence de nature, et non de degré, entre deux types de traitement. L'automatisation déterministe produit, pour des entrées identiques, des sorties identiques. Son taux d'erreur est nul hors panne technique. Le traitement par modèle d'intelligence artificielle produit, lui, un résultat probable. Il sera juste dans l'immense majorité des cas, et faux dans une petite minorité, sans que vous puissiez savoir à l'avance lesquels.
Les conséquences opérationnelles de cette différence sont concrètes et non négociables. Tout flux contenant un appel à un modèle exige trois dispositifs. Un point de vérification humaine, positionné là où l'erreur coûterait le plus cher. Une règle de repli explicite en cas d'échec : que se passe-t-il si le modèle ne répond pas, ou répond hors format ? Et une mesure du taux d'erreur, relevée dans le temps, avec un seuil au-delà duquel le flux est suspendu. Une organisation qui ne sait pas énoncer ces trois éléments n'a pas conçu un flux, elle a branché un outil.
Trois familles de tâches ne doivent pas figurer dans vos premiers chantiers, quelle que soit leur pénibilité apparente. Celles qui engagent juridiquement l'entreprise, parce que l'erreur y est irrattrapable. Celles dont le processus n'est pas stabilisé, parce que vous figeriez un désordre. Celles dont personne n'accepte d'assumer la responsabilité, parce qu'elles deviendront ingérables au premier incident.
Signaux d'éligibilité d'une tâche à l'automatisation
Volume mensuel suffisant
la tâche revient au moins une centaine de fois par mois, sous une forme comparable
Variabilité maîtrisée
le nombre de cas de figure distincts se compte sur les doigts d'une main, pas d'une dizaine de mains
Tolérance à l'erreur non nulle
une erreur occasionnelle, détectée par un contrôle, ne provoque pas de dommage irréversible
Propriétaire métier identifié
une personne nommée connaît le processus et accepte d'en répondre
Processus stabilisé
les règles n'ont pas changé au cours des six derniers mois et personne n'annonce de refonte
La grille d'éligibilité d'une tâche à l'automatisation
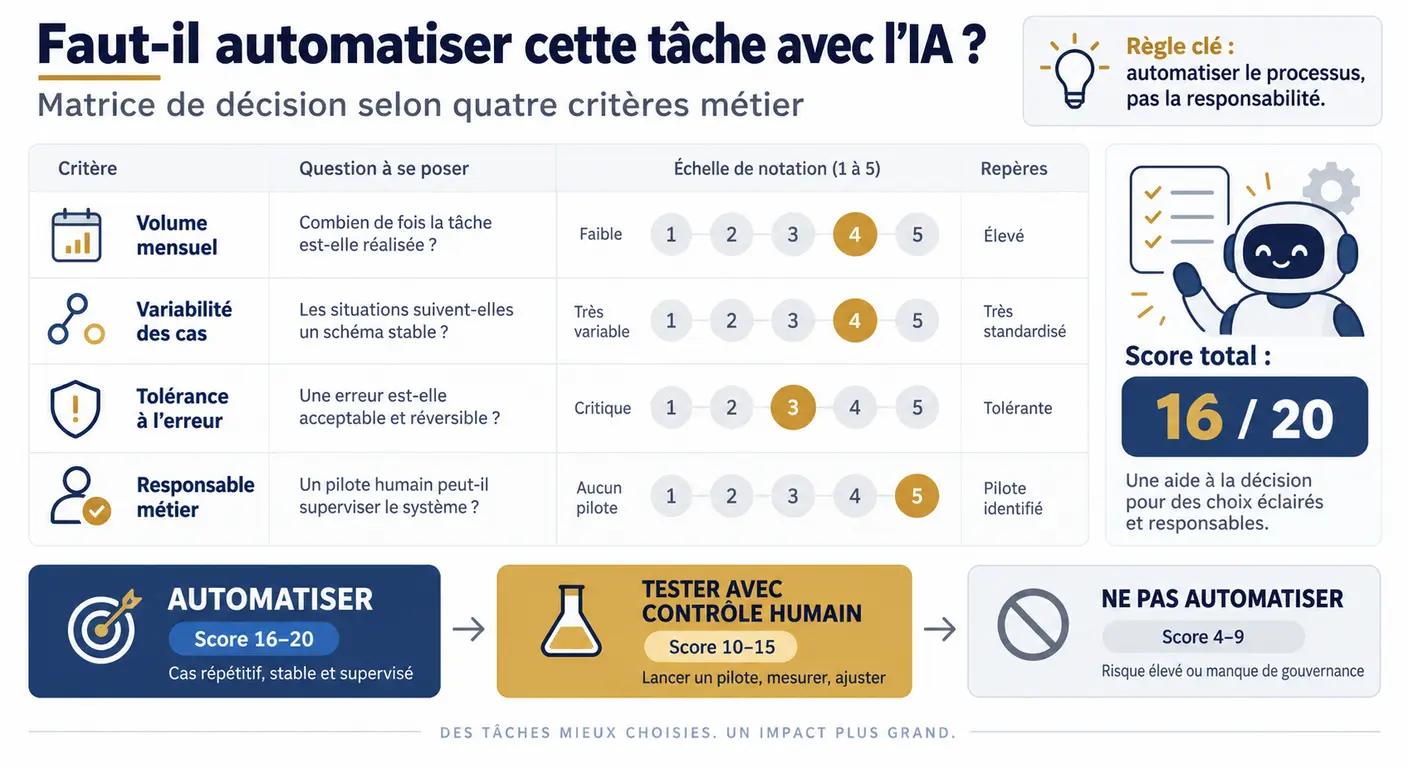
Automatiser mes tâches admin avec l'IA suppose d'abord de trier. Quatre critères suffisent, à condition de leur associer des seuils et non des impressions.
Le volume mensuel détermine si le jeu en vaut la chandelle. En dessous d'une centaine d'occurrences par mois, le temps de construction puis de maintenance dépasse fréquemment le gain, sauf si la tâche est exceptionnellement chronophage à l'unité. La variabilité des cas détermine la faisabilité : au-delà d'une dizaine de variantes de traitement, le flux devient illisible visuellement et impossible à modifier sans effet de bord. La tolérance à l'erreur détermine l'architecture : si la réponse est zéro erreur acceptable, l'intelligence artificielle n'est pas l'instrument adapté, ou alors uniquement en proposition soumise à validation intégrale. L'existence d'un propriétaire métier détermine la durabilité.
| Critère | Seuil bas | Seuil intermédiaire | Seuil favorable |
|---|---|---|---|
| Volume mensuel | Moins de 50 occurrences | 50 à 100 occurrences | Plus de 100 occurrences |
| Variabilité des cas | Plus de 10 variantes | 5 à 10 variantes | Moins de 5 variantes |
| Tolérance à l'erreur | Aucune erreur admissible | Erreur rattrapable sous 24 h | Erreur détectée par contrôle immédiat |
| Propriétaire métier | Aucun identifié | Identifié sans temps alloué | Nommé, avec temps alloué |
| Verdict | Ne pas automatiser | Automatiser avec vérification | Automatiser |
Grille d'éligibilité : quatre critères, trois seuils, un verdict
Les trois erreurs qui font échouer un projet IA no-code
La première erreur consiste à automatiser un processus non stabilisé. Le résultat est mécanique : vous figez un désordre et vous le rendez plus rapide. Les exceptions qui se réglaient par un échange informel deviennent des cas non traités, et la confiance s'effondre en quelques semaines.
La deuxième erreur consiste à construire le flux sans le futur utilisateur. L'outil fonctionne techniquement, mais il ne correspond pas à la manière dont la personne travaille réellement, et il est contourné dès le premier jour de forte charge. C'est l'objection que nous entendons le plus souvent chez les directions opérationnelles : « nous avons déjà essayé, les équipes n'ont pas adhéré. » Dans la quasi-totalité des cas, l'adhésion n'avait pas été organisée, elle avait été espérée. La conduite du changement autour de l'IA se prépare avant la construction, pas après la mise en service.
La troisième erreur consiste à ne prévoir aucun point de contrôle. L'erreur devient alors invisible jusqu'à ce qu'un client la signale, ce qui transforme un incident technique mineur en incident commercial majeur.
Conseil du coach
Un processus qu'aucun collaborateur ne sait décrire en dix lignes n'est pas prêt à être automatisé.
Où placer la vérification humaine sans annuler le gain
Une vérification intégrale annule le bénéfice : si un humain relit chaque sortie, vous avez déplacé le travail, pas réduit la charge. Le principe à appliquer est celui de la validation par exception. Le système traite tout, puis signale lui-même les cas sur lesquels il est peu sûr, et seuls ceux-là remontent à un humain.
Concrètement, vous fixez un seuil de confiance en dessous duquel le cas est mis en attente de revue. Un seuil élevé remonte beaucoup de cas et sécurise fortement, au prix d'une charge résiduelle importante. Un seuil bas laisse passer davantage d'erreurs. L'ajustement se fait par l'observation, sur les premières semaines, en comparant les cas signalés aux erreurs réellement constatées. Dans les déploiements que nous accompagnons, la charge résiduelle stabilisée se situe le plus souvent entre le dixième et le quart du volume traité.
Conseil du coach
Avant de choisir un outil, fixez le taux d'erreur que vous acceptez sur la tâche visée. Si la réponse est zéro, l'IA n'est pas le bon instrument.
Cinq cas d'usage IA no-code à gain mesurable en PME
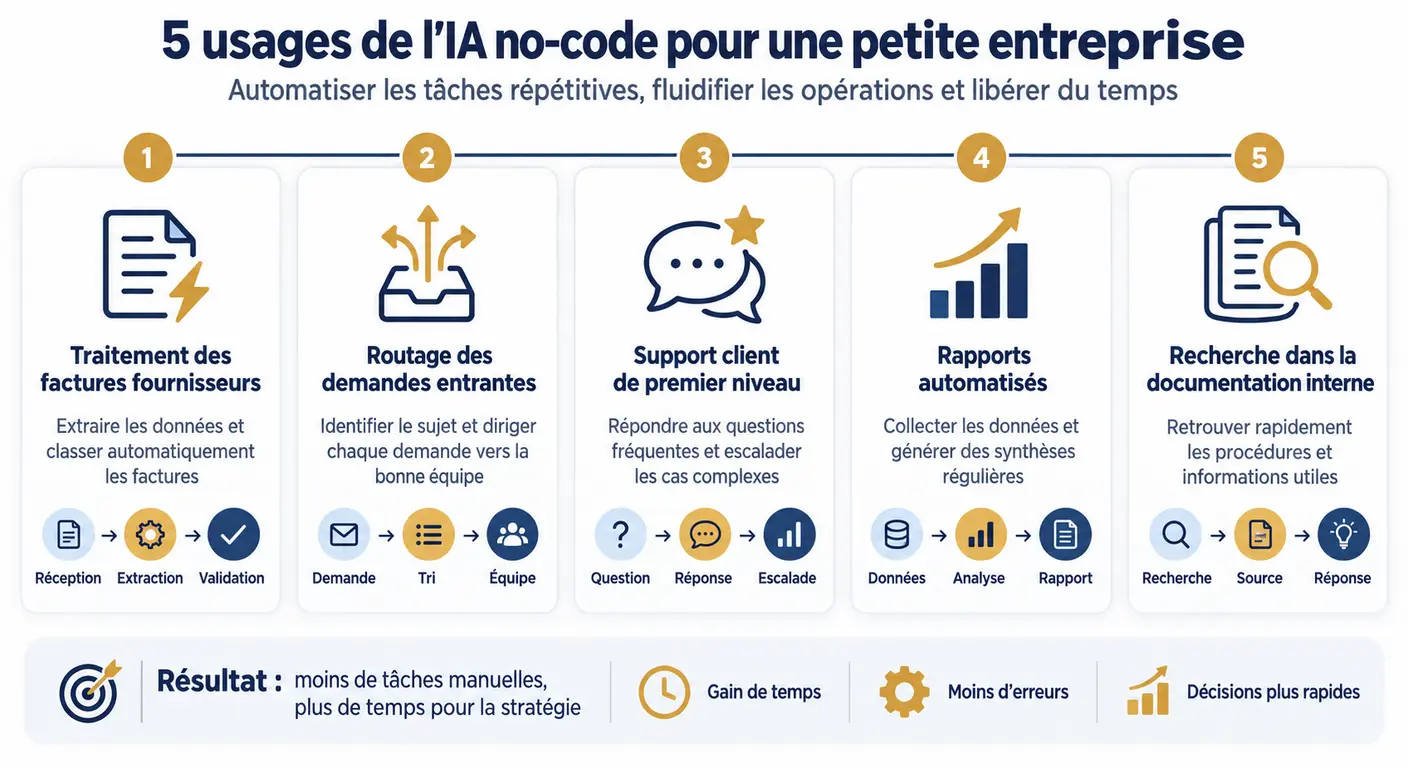
Les outils IA no-code pour PME ne valent que par les processus qu'ils touchent. Les cinq usages ci-dessous partagent une trame identique : un processus, un déclencheur, un traitement par le modèle, un point de vérification, un indicateur, un ordre de grandeur de gain et une condition d'échec. Ils sont retenus parce qu'ils réunissent volume régulier, règles descriptibles et gain observable.
Le premier est le traitement et le rapprochement des factures fournisseurs, particulièrement pertinent en cabinet comptable et dans les directions administratives. Le deuxième est la qualification et le routage des demandes entrantes, courant en commerce en ligne et en recrutement. Le troisième est la réponse de premier niveau au support client, typique du service après-vente. Le quatrième est la production de comptes rendus et de reporting à partir de données dispersées, fréquent en logistique et en direction générale. Le cinquième est l'interrogation de la documentation interne par recherche augmentée, utile dès qu'une équipe passe son temps à chercher la bonne procédure.
Un point conditionne les cinq : l'indicateur doit être relevé avant le déploiement. Sans mesure de référence, aucun gain ne sera démontrable, et le débat en comité de direction se réglera à l'impression. C'est le point sur lequel les chiffres de productivité disponibles sur le marché ne vous seront d'aucun secours : seule votre mesure fait foi chez vous.
- 2 semainesdurée minimale d'une période de référence exploitable avant automatisation
- 1 indicateurnombre de mesures à retenir par cas d'usage, pour rester incontestable en comité
- 10 à 25 %part du volume qui reste en revue humaine après stabilisation d'un flux avec validation par exception
Observations Centauri sur missions PME et ETI, 2024-2026
| Processus | Indicateur à relever avant | Ordre de grandeur du gain | Principal risque |
|---|---|---|---|
| Factures fournisseurs | Temps moyen de traitement par facture | Réduction de moitié à deux tiers du temps de saisie | Extraction erronée sur formats inhabituels |
| Demandes entrantes | Délai de première réponse | Passage de quelques heures à quelques minutes | Mauvais routage sur demandes ambiguës |
| Support de premier niveau | Taux de résolution au premier contact | Absorption d'une part significative des demandes répétitives | Réponse inventée hors base documentaire |
| Reporting consolidé | Temps de production mensuel du rapport | Réduction forte du temps de collecte, pas de l'analyse | Données sources non rafraîchies |
| Documentation interne | Temps moyen de recherche d'une procédure | Accès quasi immédiat aux réponses documentées | Documents obsolètes ou droits mal cloisonnés |
Traitement des factures et rapprochement comptable
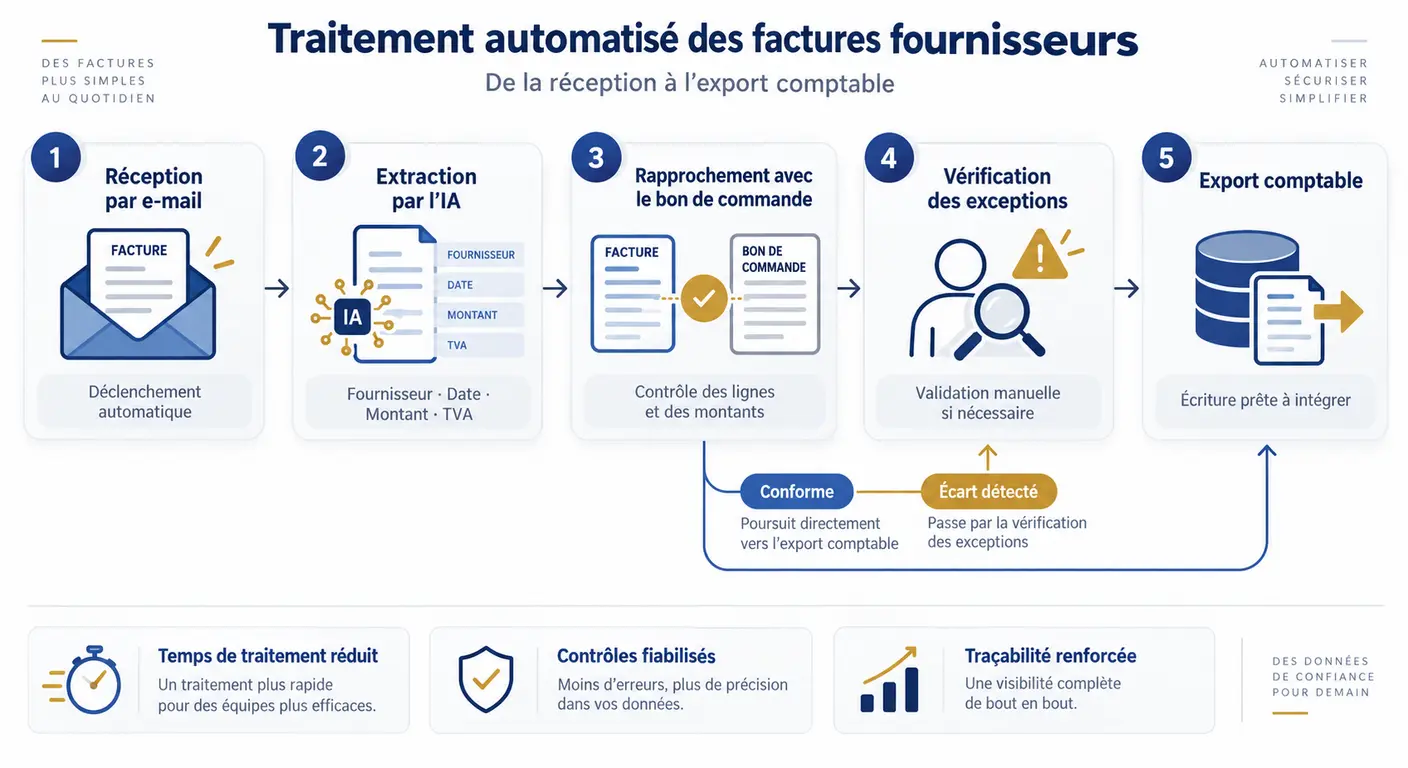
Le déclencheur est l'arrivée d'une pièce dans une boîte dédiée ou un espace de dépôt. Le modèle extrait les champs — fournisseur, numéro, date, montant hors taxes, taxe, échéance — puis le flux tente le rapprochement avec la commande correspondante. La vérification humaine porte exclusivement sur les écarts de montant et sur les pièces que le système signale comme mal lues. L'export vers l'outil comptable ferme la chaîne.
Deux indicateurs suffisent : le temps moyen de traitement par facture et le taux de rejet en comptabilité. Relevez-les sur un mois complet, période de clôture incluse, faute de quoi votre référence sera flatteuse. Le risque principal reste l'extraction erronée sur des formats de facture inhabituels, typiquement les documents scannés de travers ou les factures étrangères en plusieurs devises. La parade est simple : restreindre le périmètre initial à vos vingt fournisseurs les plus fréquents, qui représentent souvent l'essentiel du volume. C'est la voie la plus directe vers une réduction des délais de traitement mesurable.
Qualification des demandes entrantes et réponses de premier niveau
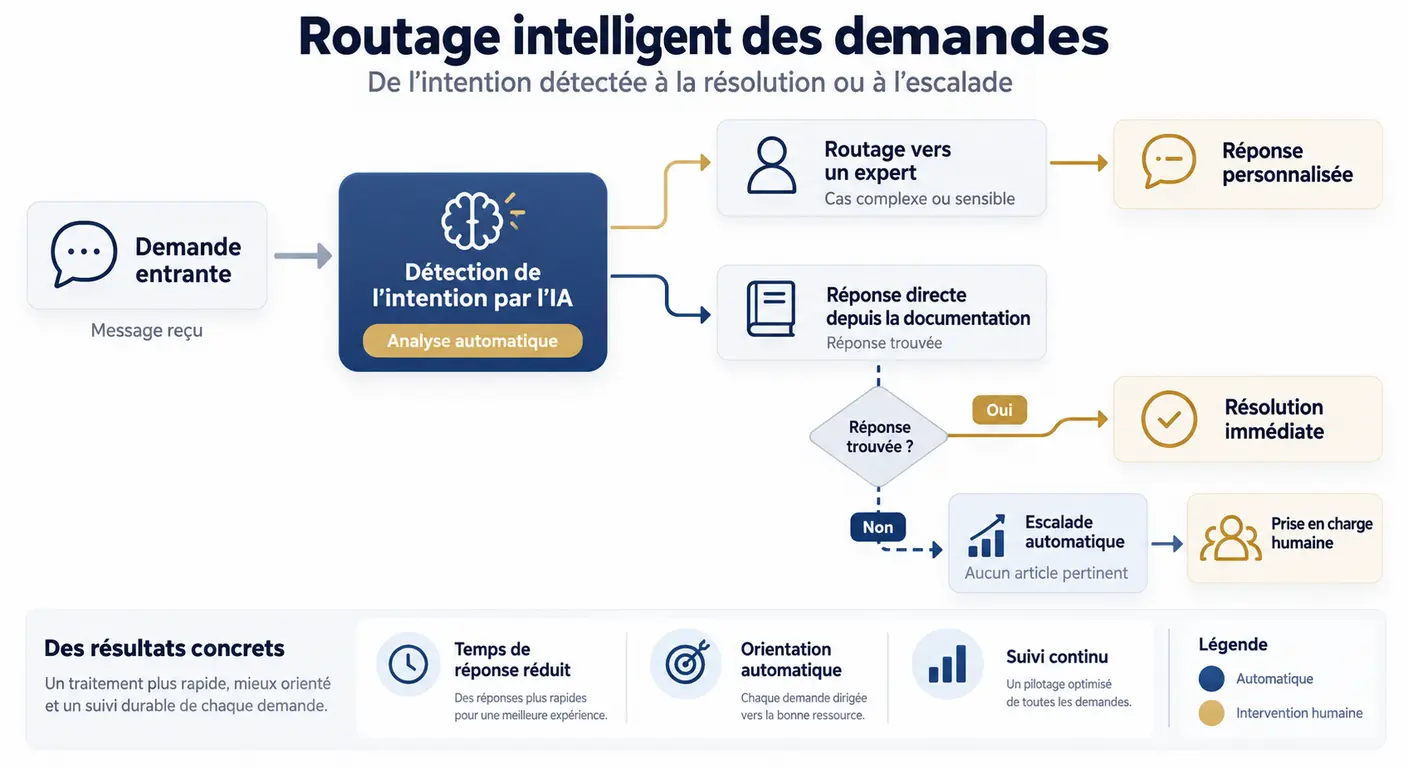
Le routage des messages et l'assistant conversationnel relèvent de la même architecture et gagnent à être traités ensemble : un message arrive, le modèle en identifie l'intention, puis le flux décide soit d'orienter vers la bonne personne, soit de répondre directement à partir d'une base documentaire.
La vérification humaine prend ici la forme d'une escalade automatique. Dès que le modèle ne trouve pas d'élément de réponse dans la documentation, il passe la main sans tenter de formuler quoi que ce soit. Cette contrainte est le point de conception le plus important de tout le cas d'usage, et elle doit être posée avant de choisir la solution. Les indicateurs pertinents sont le taux de résolution au premier contact et le délai de première réponse, deux mesures que la plupart des outils de support fournissent déjà. Le risque d'échec est concentré sur les demandes ambiguës et sur les clients mécontents, qu'il vaut mieux exclure explicitement du périmètre automatisé. Un assistant de support client bien cadré répond peu, mais répond juste.
Conseil du coach
Un assistant qui invente une réponse coûte plus cher qu'un formulaire. Contraignez-le à ne répondre qu'à partir de vos documents, et à passer la main sinon.
Reporting automatisé et interrogation de la documentation interne
La consolidation de données dispersées suit une logique différente : le déclencheur est calendaire, le flux collecte dans plusieurs sources, le modèle rédige la synthèse, et un responsable valide avant diffusion. Le gain porte sur le temps de collecte et de mise en forme, jamais sur l'analyse, qui reste humaine. Mesurez le temps de production mensuel du rapport avant de commencer, sans oublier les allers-retours de correction. Le principe vaut aussi bien pour un reporting construit sur tableur que pour un tableau de bord d'activité.
L'interrogation de la documentation interne est l'usage le plus exigeant des cinq. Sa qualité ne dépend pas du modèle mais de vos documents : une procédure obsolète produira une réponse fausse avec le même aplomb qu'une procédure à jour. Deux conditions doivent être posées dès le départ, la fraîcheur des sources, avec une date de dernière revue visible, et le respect strict des droits d'accès, afin qu'un collaborateur ne puisse pas obtenir par le biais de l'assistant une information à laquelle il n'a pas accès autrement.
Panorama des plateformes : automatiser, dialoguer, interroger ses documents
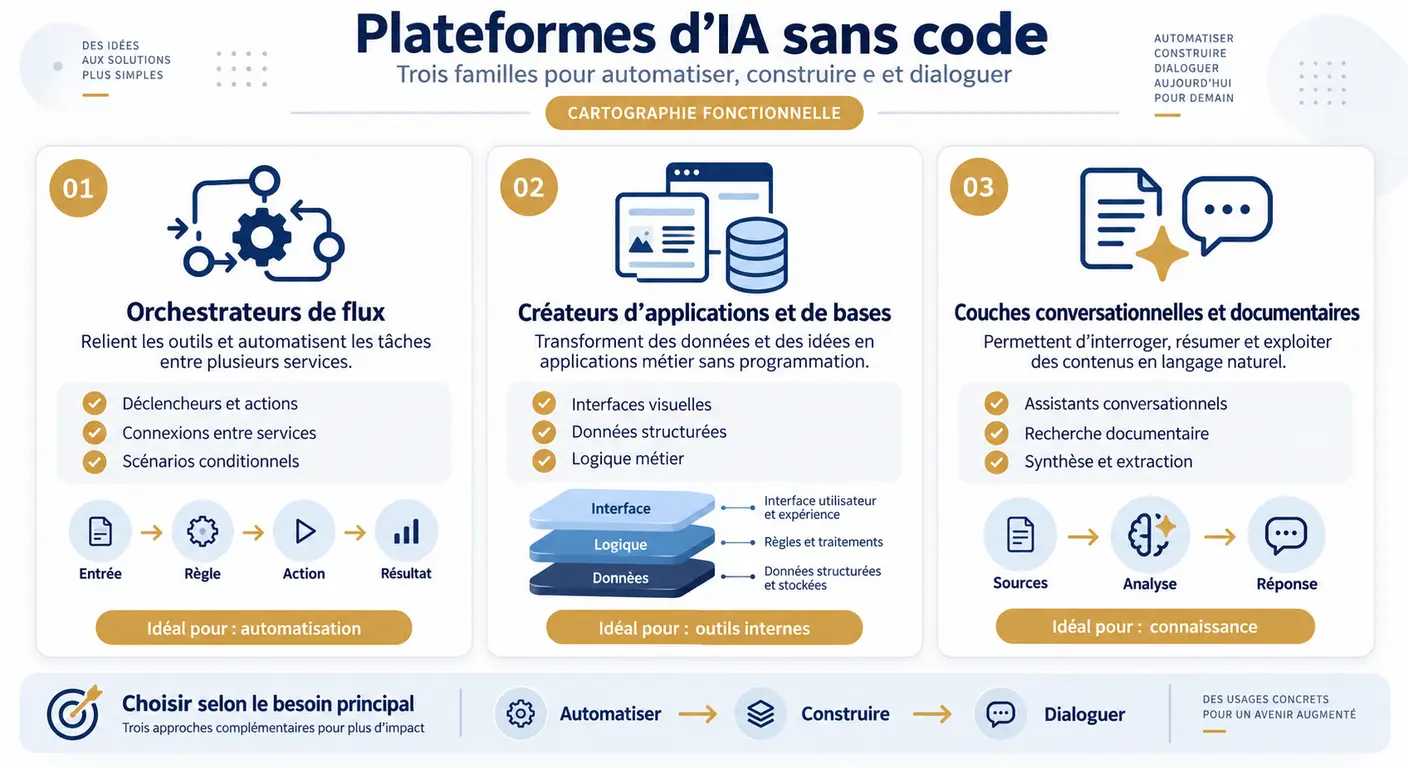
Classer les plateformes par marque produit un inventaire périmé en six mois. Les organiser par fonction produit une grille de lecture durable. Une plateforme no-code intelligence artificielle appartient à l'une de ces trois familles, et le critère de choix diffère radicalement de l'une à l'autre.
Les orchestrateurs de flux relient vos logiciels entre eux et exécutent des enchaînements en arrière-plan : Zapier privilégie la simplicité d'usage, Make la lisibilité des scénarios ramifiés, n8n la possibilité d'héberger la solution sur votre propre infrastructure. Les constructeurs d'applications et de bases produisent des outils que vos équipes manipulent : Airtable et Notion pour structurer des données, Bubble, Glide, Softr ou WeWeb pour livrer une interface. Les couches conversationnelles et documentaires servent à dialoguer avec un corpus de documents. Ces trois familles sont complémentaires, et une PME en combine souvent deux.
La question de l'hébergement européen mérite d'être posée dès le choix, et non au moment de l'audit. Certaines plateformes proposent une exécution dans l'Union européenne, d'autres une version installable sur vos serveurs. Ces options ont un coût en compétences, mais elles changent la nature de la conversation avec votre direction des systèmes d'information. Aucune plateforme n'est recommandable dans l'absolu : chacune l'est sous conditions, et ces conditions dépendent de votre volumétrie, de votre sensibilité de données et de votre capacité d'administration. Les différences entre les principaux orchestrateurs sans code se jouent sur ces points, pas sur le nombre de connecteurs annoncé.
| Critère | Orchestrateur hébergé | Orchestrateur auto-hébergé | Plateforme applicative |
|---|---|---|---|
| Compétence requise | Référent métier formé | Administration serveur nécessaire | Référent métier et notions de modélisation |
| Modèle de facturation | À la tâche ou à l'opération | Coût d'infrastructure fixe | Par utilisateur actif |
| Localisation des données | Selon l'éditeur | Maîtrisée par l'entreprise | Selon l'éditeur |
| Réversibilité | Export de la logique variable | Totale, flux exportables | Dépend de l'accès à la base |
| Adéquation au système existant | Bonne via connecteurs standard | Bonne, extensible sur mesure | Variable selon les interfaces disponibles |
Trois familles de plateformes comparées sur cinq critères de décision
Orchestrateurs de flux : le critère qui tranche est la facturation
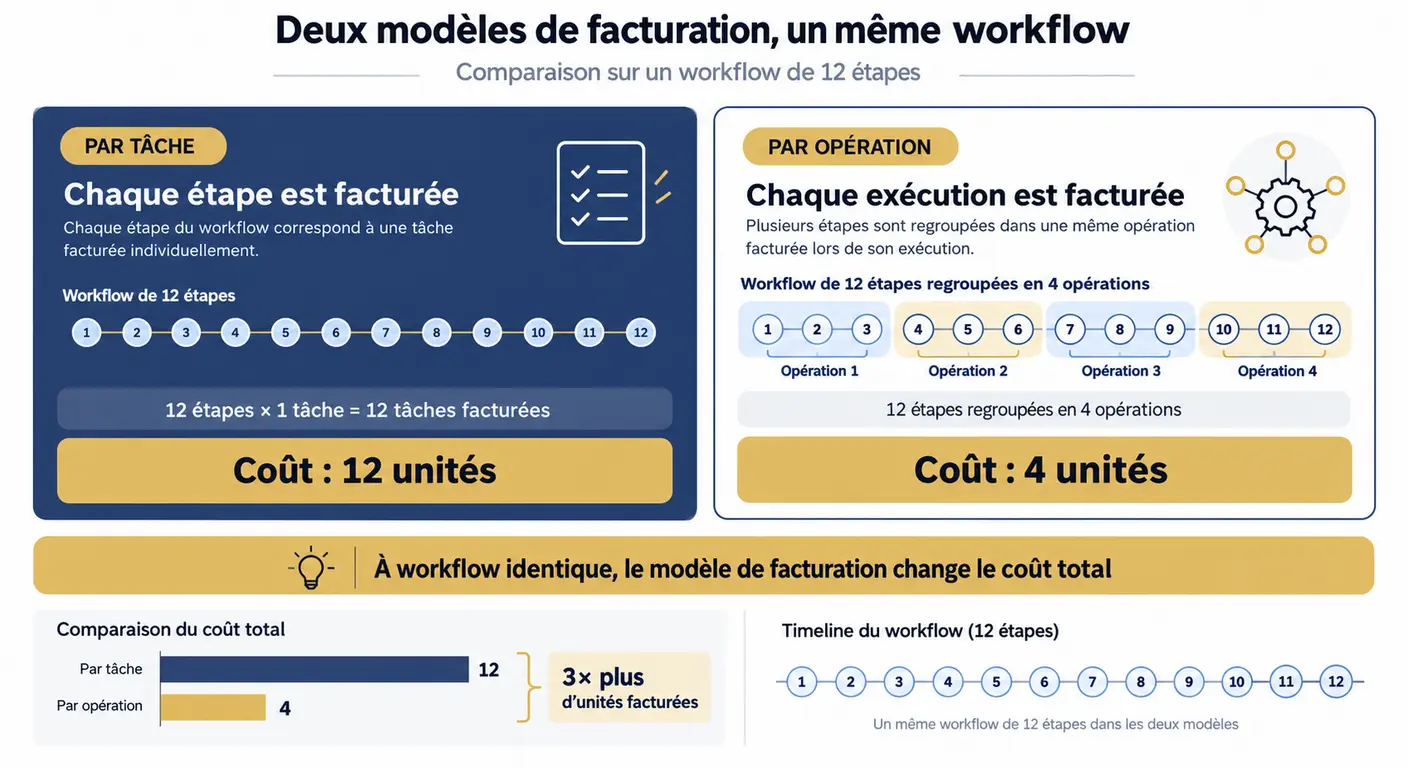
Deux modèles de facturation coexistent et produisent des écarts considérables sur un même flux. Le premier facture la tâche exécutée, c'est-à-dire le déclenchement complet du scénario, quel que soit le nombre d'étapes. Le second facture l'opération élémentaire, chaque étape comptant individuellement. Un flux de traitement de factures comportant douze étapes coûtera donc, à volume identique, un ordre de grandeur différent selon la plateforme retenue.
La règle pratique est simple : comptez le nombre d'étapes de votre flux, multipliez par le volume mensuel attendu, et confrontez ce total aux paliers tarifaires des deux modèles. Faites-le avant de construire, car changer d'orchestrateur en cours de route revient à tout reconstruire. L'option auto-hébergée supprime cette facturation à l'usage mais suppose une compétence d'administration, une politique de sauvegarde et une responsabilité de mise à jour, qui ont elles aussi un coût.
Constructeurs d'applications : la réversibilité avant la facilité
La question rarement posée au moment du choix est pourtant la seule qui compte à trois ans : que récupérez-vous si vous partez ? Certaines plateformes exposent franchement leur base de données, avec un export complet dans un format ouvert et une interface de programmation documentée. D'autres enferment la structure, et ne restituent qu'un fichier plat privé de ses relations, ce qui rend la reprise coûteuse.
Le même raisonnement s'applique à la logique métier. Si une règle de calcul n'existe que dans une formule saisie dans l'interface de l'éditeur, elle disparaît avec l'abonnement. Cette exigence prend toute son importance dès que la plateforme se raccorde à vos logiciels de gestion : une intégration avec votre outil de relation client crée une dépendance croisée qu'il faut pouvoir démonter.
Conseil du coach
Avant de construire, vérifiez comment vous exportez. Une base que vous ne pouvez pas extraire est une dépendance, pas un outil.
Couche conversationnelle et recherche documentaire : contrôler la source
Le principe est plus simple que son vocabulaire. Au lieu de laisser le modèle répondre à partir de ce qu'il a appris, on lui fournit, à chaque question, les extraits pertinents de vos propres documents, et on lui demande de répondre uniquement à partir de ceux-ci. La réponse est ainsi ancrée sur une source que vous contrôlez, et qu'un lecteur peut vérifier.
La conséquence pratique déroute souvent les directions : la qualité du résultat dépend bien davantage de l'organisation de vos documents que du modèle choisi. Un corpus rangé, daté, débarrassé des versions périmées et cloisonné par droits d'accès produira de bonnes réponses avec un modèle courant. Un corpus désordonné produira des réponses médiocres avec le meilleur modèle du marché. Mettre en place un agent IA conversationnel sans développeur commence donc par un travail documentaire, pas par un choix technique.
Combien coûte réellement une solution IA no-code sur 24 mois
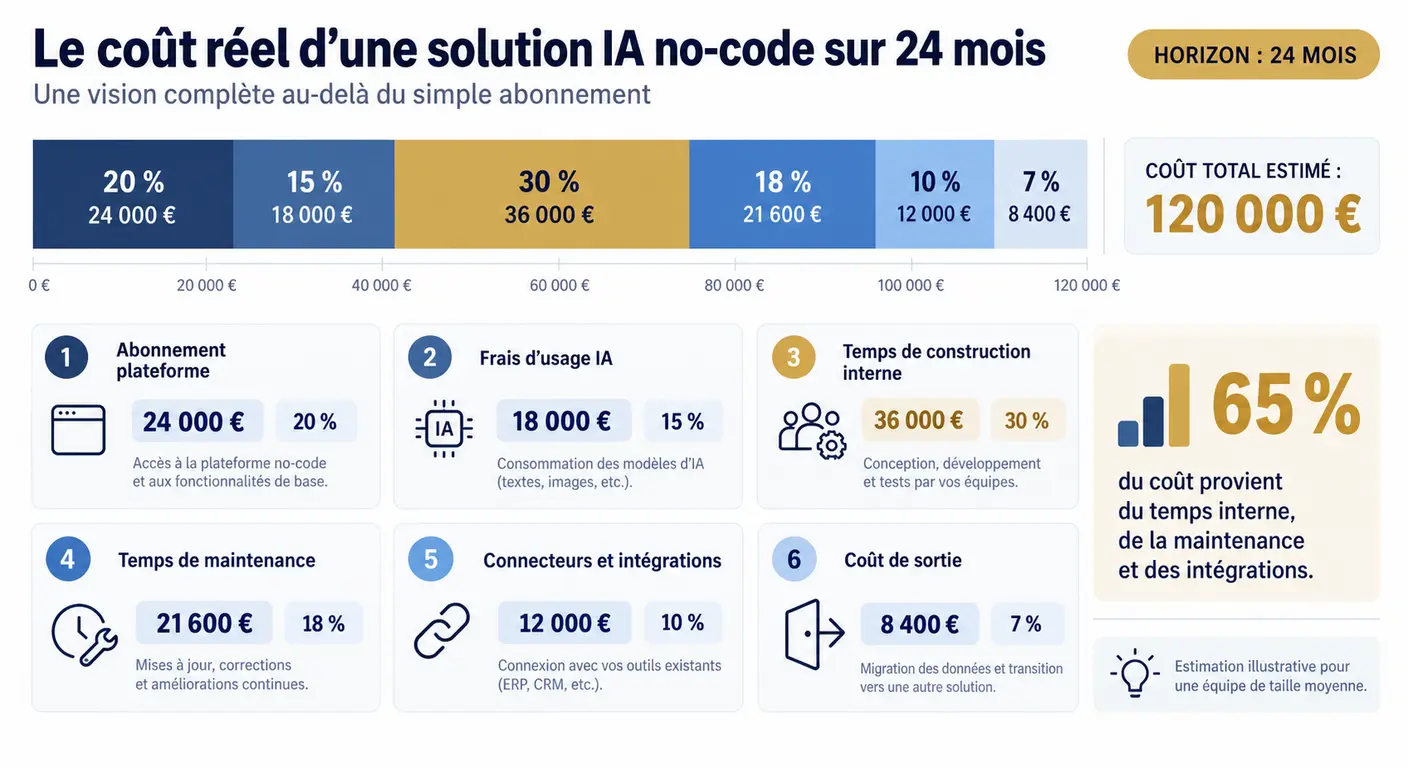
L'annonce d'un abonnement à quelques dizaines d'euros par mois est exacte et trompeuse à la fois. Exacte, parce que c'est bien le prix affiché. Trompeuse, parce qu'elle ne couvre qu'un poste sur six. Une solution IA clé en main PME se budgète sur vingt-quatre mois, en additionnant : l'abonnement à la plateforme ; la consommation facturée à l'usage du modèle d'intelligence artificielle, proportionnelle au volume traité ; le temps interne de construction ; le temps interne de maintenance et de correction ; le coût des connecteurs et services annexes, souvent facturés séparément ; et le coût de sortie ou de reprise, le jour où vous changerez d'outil.
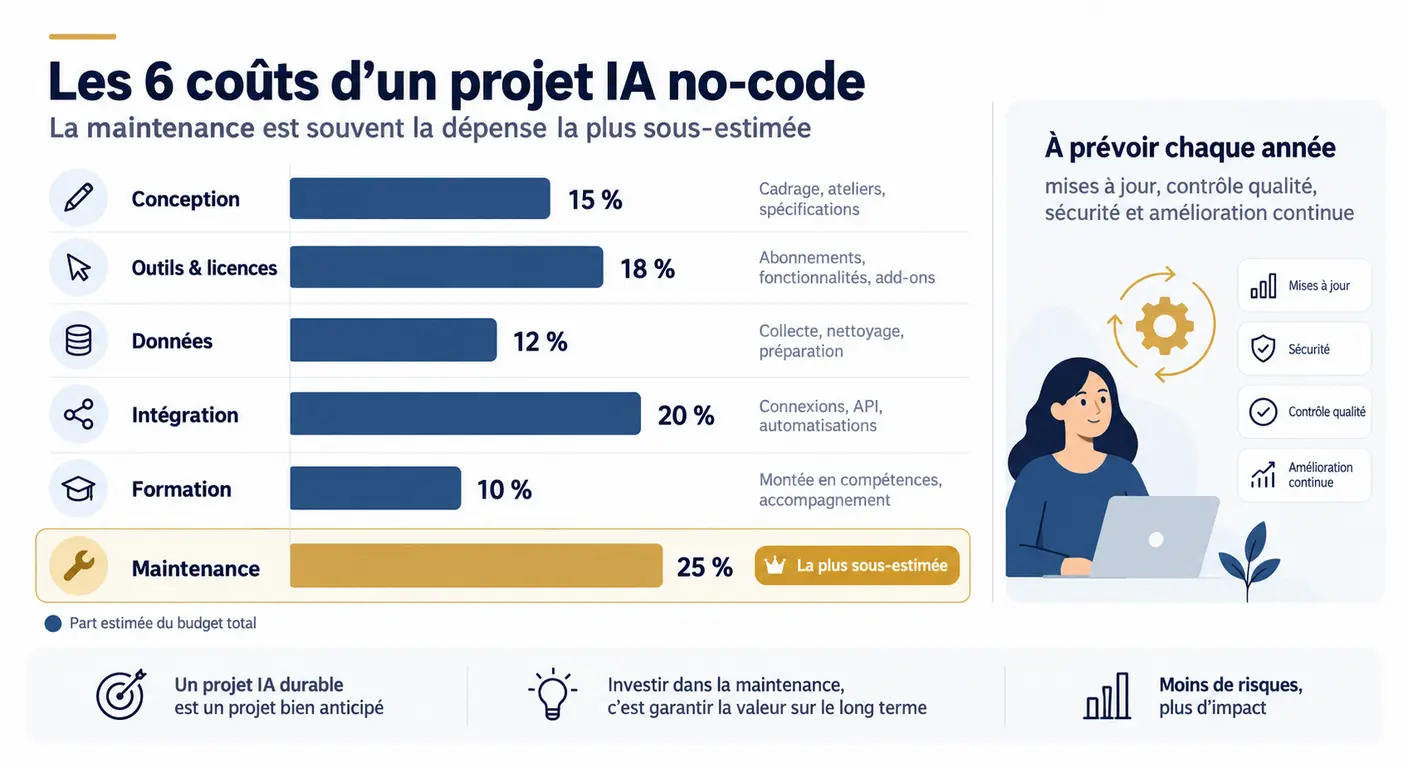
Le poste le plus systématiquement sous-estimé est la maintenance. Un connecteur change, une interface évolue, une règle métier se modifie, un format de document apparaît : dans les portefeuilles que nous suivons, un flux en production consomme rarement moins de quelques heures par mois. Multipliez par le nombre de flux et par vingt-quatre, valorisez au coût chargé de la personne concernée, et vous obtiendrez un montant sans commune mesure avec l'abonnement. Cette modélisation est la base de tout calcul de retour sur investissement défendable.
| Poste de coût | Un flux, faible volume | Trois flux, volume moyen | Portefeuille en production |
|---|---|---|---|
| Abonnement plateforme | Palier d'entrée | Palier intermédiaire | Palier entreprise ou auto-hébergement |
| Consommation du modèle | Marginale | Proportionnelle au volume, poste visible | Poste majeur à surveiller mensuellement |
| Temps interne de construction | Quelques jours | Quelques semaines cumulées | Fonction dédiée à temps partiel |
| Maintenance et correction | 1 à 2 h par mois | 5 à 10 h par mois | Charge récurrente structurée |
| Connecteurs et services annexes | Inclus | Quelques abonnements complémentaires | Contrats négociés |
| Coût de sortie ou de reprise | Faible | Modéré si la logique est documentée | Élevé, à provisionner |
Structure de coût sur 24 mois selon trois scénarios volumétriques
Les six postes de coût que les comparatifs oublient
Chaque poste s'estime avant engagement, à condition de savoir où regarder. L'abonnement plateforme se lit sur la grille tarifaire, en vérifiant le palier correspondant à votre volume réel et non au volume d'essai. La consommation du modèle s'estime en multipliant le volume mensuel par le coût unitaire d'un traitement, mesuré sur une dizaine de cas réels pendant la phase de test. Le temps de construction se mesure en journées de la personne référente, à valoriser au coût chargé.
La maintenance s'estime par analogie : comptez deux à quatre heures par mois et par flux la première année, davantage si le flux touche plusieurs logiciels. Les connecteurs et services annexes se repèrent en listant tout ce qui n'est pas la plateforme principale : outil de reconnaissance de document, espace de stockage, service de notification. Le coût de sortie, enfin, s'estime en répondant à une question : combien de jours faudrait-il pour reconstruire ailleurs ce que vous aurez construit ici ? Ces six lignes constituent le socle d'une analyse budgétaire complète d'un déploiement en PME.
À partir de quel volume le développement dédié redevient pertinent
Deux seuils méritent une surveillance mensuelle. Le premier est financier : rapportez le coût mensuel d'exécution du flux, consommation du modèle incluse, au coût d'un développement équivalent amorti sur trois ans. Dès que le premier approche le second, la question de la réinternalisation doit être posée en comité, sans passion.
Le second seuil est structurel : comptez les branches conditionnelles de votre flux. Au-delà d'une dizaine, l'interface visuelle cesse d'être un avantage et devient un handicap, parce que plus personne ne peut vérifier d'un coup d'œil ce que fait réellement l'enchaînement. Un troisième signal s'ajoute parfois : la criticité. Un flux dont la panne affecterait directement vos clients relève d'une exigence de supervision que les plateformes visuelles couvrent mal. Un seul signal justifie une revue ; deux simultanés justifient de planifier la bascule. Cette bascule est une réussite du no-code, qui aura permis de valider l'usage avant d'investir.
Conseil du coach
Un flux qui ne tient plus sur un écran est un flux qui va casser. C'est le signal de réinternalisation le plus fiable.
Construire un argumentaire chiffré pour son comité de direction
Un dossier défendable tient en quatre parties, et aucune ne peut manquer. Le coût complet sur vingt-quatre mois, avec les six postes détaillés et les hypothèses de volume assumées. Le gain mesuré sur une période de référence identifiée, exprimé dans l'unité de la fonction concernée — heures, délai, taux d'erreur — et non en pourcentage abstrait. Le risque résiduel, décrit sans euphémisme : que se passe-t-il si le modèle se trompe, qui le détecte, en combien de temps. La condition de sortie enfin : à quel signal arrêtez-vous, et que récupérez-vous alors.
Un comité de direction n'attend pas une promesse de transformation, il attend une décision documentée avec ses conditions de révision. Un dossier qui présente ses propres limites est plus solide qu'un dossier qui n'en présente aucune, et il résiste mieux à la première difficulté d'exécution.
Conformité, sécurité et réversibilité : le cadre à poser avant de déployer
La question centrale se formule en une phrase : quand un flux appelle un modèle hébergé hors de l'Union européenne, quelles données sortent de votre périmètre, sous quel statut juridique, et sur quelle base légale ? Y répondre avant le déploiement coûte quelques heures. Y répondre après un incident coûte davantage.
Trois éléments doivent être établis pour chaque fournisseur appelé par vos flux. Sa qualification : il agit comme sous-traitant au sens du règlement européen sur la protection des données, ce qui suppose un contrat encadrant le traitement. La durée de conservation de votre côté comme du sien, avec la garantie explicite que vos contenus ne servent pas à entraîner de modèle. La localisation effective du traitement, qui n'est pas toujours celle du siège de l'éditeur. Certaines configurations, notamment un traitement à grande échelle de données sensibles ou un profilage, imposent en outre une analyse d'impact préalable. Ces vérifications relèvent d'une gouvernance des données claire, pas d'un avertissement en fin de projet.
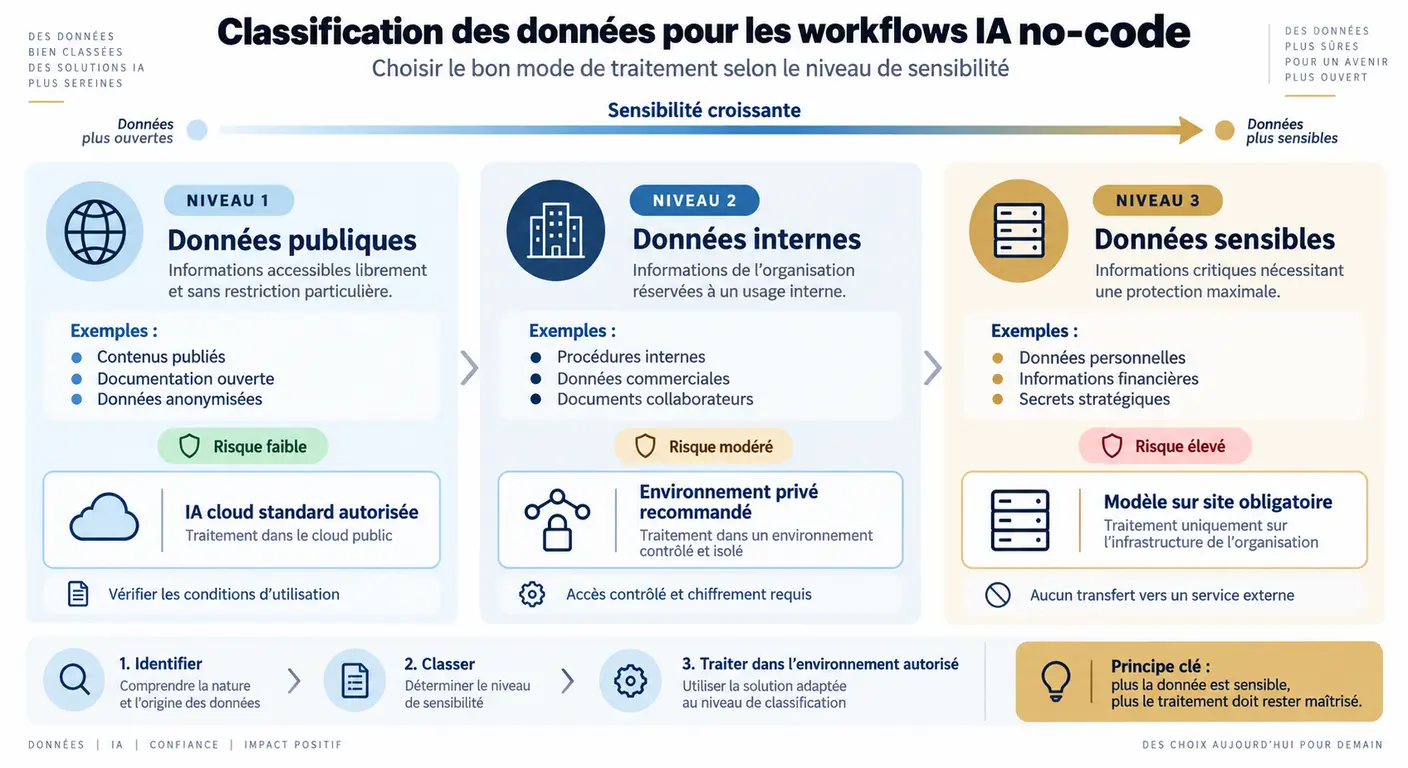
| Niveau de donnée | Exemples | Règle de traitement applicable |
|---|---|---|
| Publique ou interne banale | Documentation produit, procédures internes non confidentielles | Plateformes standard admises, sans exigence particulière de localisation |
| Personnelle courante | Coordonnées client, candidatures, correspondance commerciale | Hébergement dans l'Union européenne, contrat de sous-traitance, non-réutilisation garantie, durée de conservation limitée |
| Sensible ou stratégique | Données de santé, éléments prud'homaux, secrets industriels, données financières non publiées | Traitement sur infrastructure maîtrisée ou modèle exécuté en interne ; anonymisation préalable si sortie inévitable |
Règle applicable aux données sensibles
Aucune donnée classée sensible ou stratégique ne doit transiter par un flux appelant un service externe tant que trois conditions ne sont pas réunies : une base légale documentée, un contrat de sous-traitance couvrant explicitement le traitement, et une localisation de traitement vérifiée. À défaut de ces trois éléments, la seule option conforme reste un modèle exécuté sur une infrastructure que vous maîtrisez, ou l'anonymisation préalable des données transmises. Cette règle prime sur toute considération de gain opérationnel.
Le risque le plus concret en pratique n'est pourtant ni le transfert ni le contrat : c'est la prolifération de flux non documentés, construits de bonne foi par des équipes métier, et invisibles de la direction des systèmes d'information. Un registre minimal en cinq colonnes suffit à reprendre la main.
Pratiques à proscrire dans un déploiement d'IA no-code
Flux sans propriétaire nommé
personne ne sait qui décide de l'arrêter ou de le modifier
Données personnelles transmises sans contrat de sous-traitance
le traitement est irrégulier dès la première exécution
Comptes partagés entre plusieurs collaborateurs
toute traçabilité des actions devient impossible
Documentation de la logique métier existant uniquement dans la plateforme
la règle disparaît avec l'abonnement
Absence de date de dernière revue
un flux non revu depuis un an ne reflète plus le processus réel
Ce qui sort réellement de l'entreprise quand un flux appelle un modèle
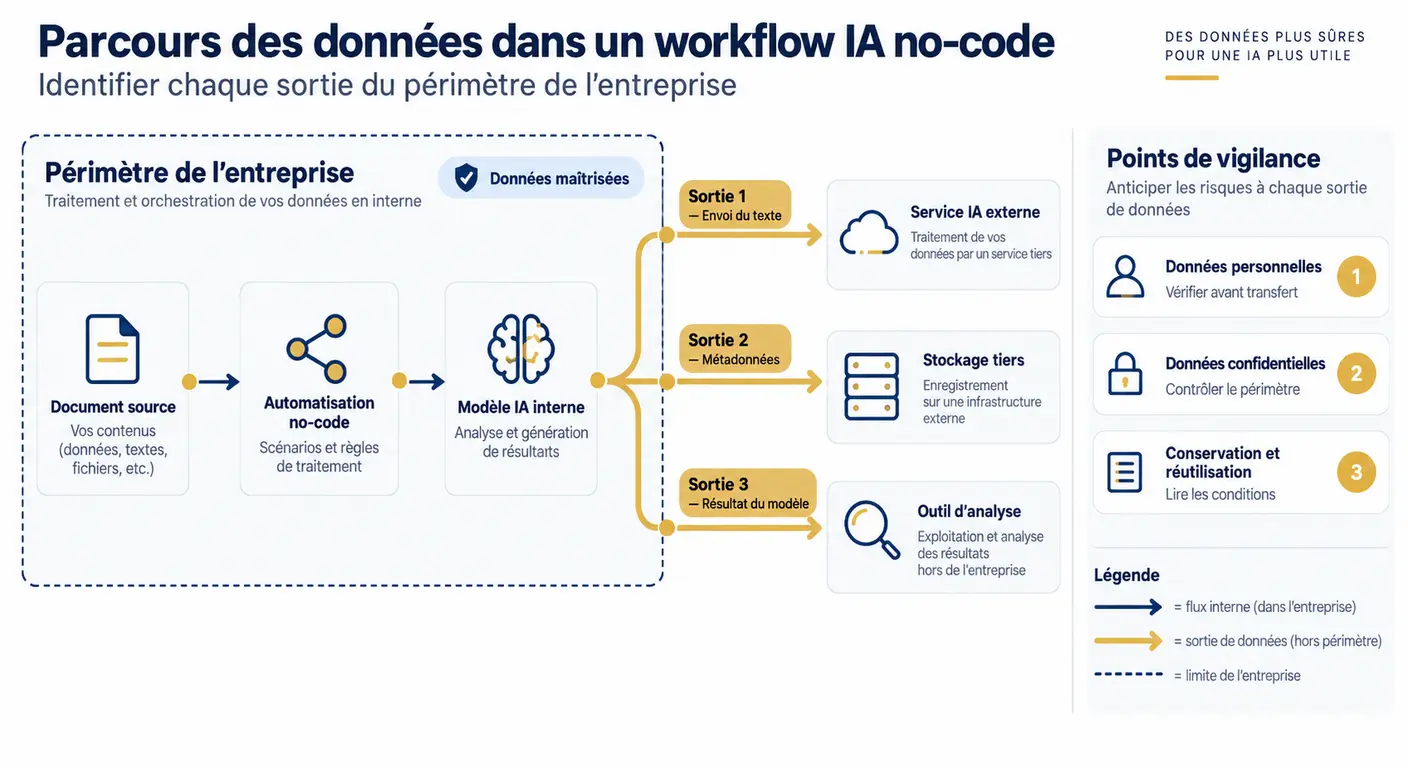
Suivons une facture, étape par étape. Elle arrive dans une boîte de messagerie hébergée par un fournisseur : premier point de sortie, généralement déjà couvert par un contrat existant. Le flux la récupère via la plateforme d'orchestration : deuxième point, car la pièce transite par les serveurs de l'éditeur, parfois stockée temporairement. La pièce est envoyée au service d'extraction ou au modèle d'intelligence artificielle : troisième point, le plus sensible, car le contenu intégral du document est transmis. Le résultat structuré revient et alimente votre outil comptable : quatrième point, interne cette fois.
Trois sorties sur quatre échappent donc à votre infrastructure. Cette cartographie ne conduit pas nécessairement à renoncer, mais elle permet de choisir où agir : chiffrer le stockage intermédiaire, réduire la durée de rétention côté plateforme, masquer certains champs avant transmission, ou basculer la seule étape d'interprétation vers une solution maîtrisée. Ce raisonnement est celui d'une approche structurée de la protection des données dans le cloud.
Encadrer le développement par les métiers sans l'interdire
Déployer l'IA sans équipe technique dédiée suppose que des équipes métier construisent. L'interdire produit du contournement, sur des comptes personnels et des outils gratuits, donc exactement l'inverse de la sécurité recherchée. Trois règles suffisent à encadrer sans bloquer.
Première règle : déclaration obligatoire. Tout flux construit est inscrit au registre avant sa mise en service, avec cinq colonnes — nom du flux, propriétaire, données traitées, services externes appelés, date de dernière revue. Deuxième règle : classification préalable. Le propriétaire indique le niveau de donnée traité, ce qui déclenche mécaniquement la règle applicable. Troisième règle : revue périodique, semestrielle au minimum, où chaque flux est confirmé, ajusté ou arrêté. Ce cadre tient en une page et se met en place en une demi-journée.
Conseil du coach
Interdire les outils no-code ne les fait pas disparaître, cela les rend invisibles. Déclarez-les, classez-les, revoyez-les.
Réversibilité : préparer la sortie dès la conception
Trois exigences se posent au moment du choix de la plateforme, pas au moment du départ. La première est l'export complet des données dans un format ouvert et exploitable, relations comprises, testé une fois avant la mise en production. La deuxième est une documentation exportable de la logique du flux, sous forme de fichier lisible hors de l'outil. La troisième est l'absence de règle métier existant uniquement dans la plateforme : toute règle de calcul ou de décision doit être écrite ailleurs, dans un document de référence tenu à jour.
Ces trois exigences ne coûtent presque rien au démarrage et déterminent entièrement votre marge de manœuvre à trois ans. Elles valent aussi bien pour un changement de fournisseur que pour un passage vers un développement dédié.
Déployer l'IA sans équipe technique : méthode en 90 jours
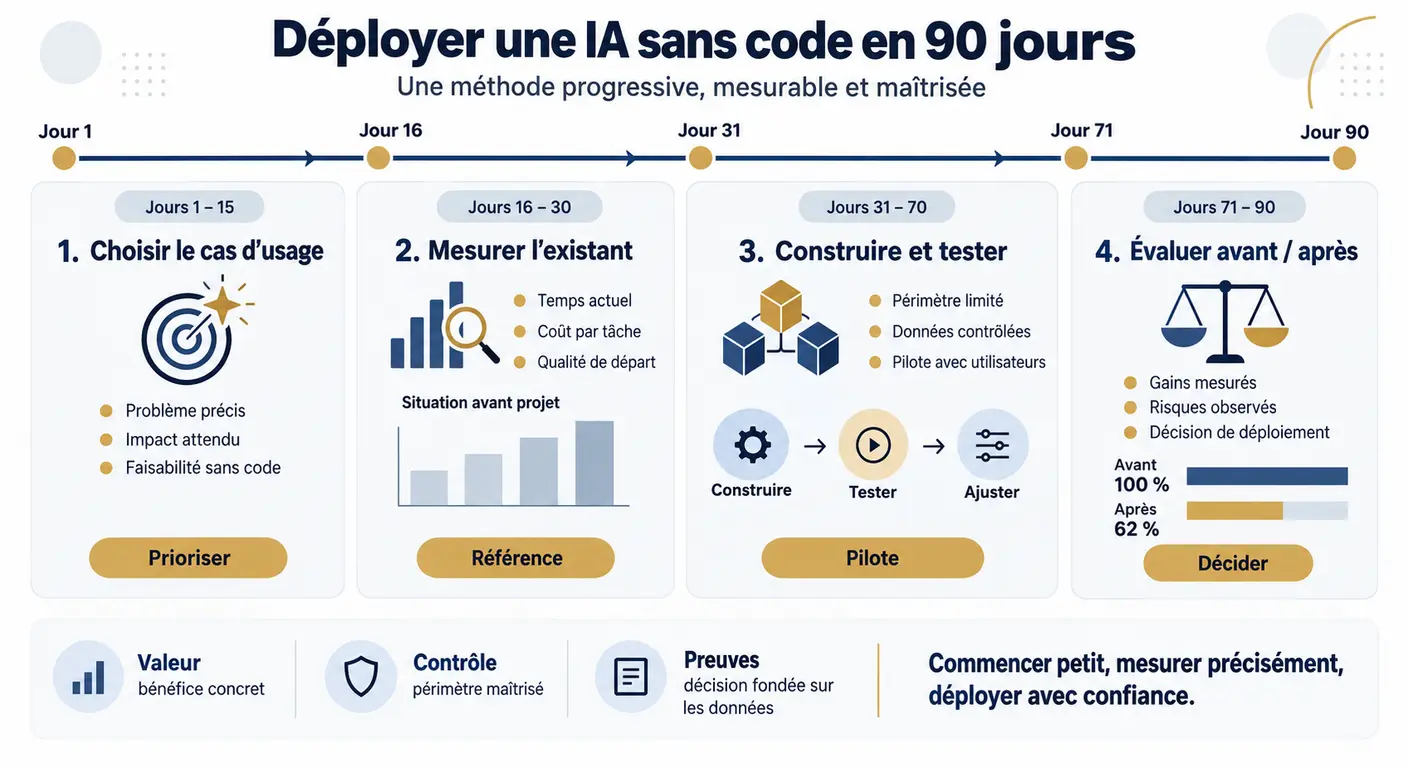
La séquence ci-dessous se déroule en quatre phases, chacune associée à un livrable et à un critère de passage. Son intérêt n'est pas la rapidité, mais le fait qu'elle produit une décision documentée au terme du trimestre.
Phase 1, jours 1 à 15 : inventaire des processus candidats et application de la grille d'éligibilité. Livrable attendu, une liste priorisée de trois cas, avec pour chacun le verdict issu des quatre critères. Phase 2, jours 16 à 30 : relevé des indicateurs avant automatisation et cadrage du cas retenu. Livrable, une mesure de référence documentée, datée et validée par le responsable du service concerné. Phase 3, jours 31 à 60 : construction du flux, mise en place du point de vérification, test sur un périmètre volontairement restreint. Livrable, un flux en fonctionnement encadré. Phase 4, jours 61 à 90 : mesure après, puis décision de généralisation, d'ajustement ou d'arrêt. Livrable, une comparaison avant-après documentée.
L'arrêt est une issue légitime, et il faut le dire avant de commencer. Un dispositif qui ne prévoit pas cette issue ne produit pas des outils performants, il produit des outils maintenus par habitude, dont plus personne n'ose questionner l'utilité. Cette logique de jalons rejoint celle d'une feuille de route sur six mois, dont le premier trimestre reprend exactement cette séquence.
Les quatre phases d'un déploiement en 90 jours
Jours 1 à 15, sélection
inventorier les processus candidats, appliquer la grille d'éligibilité, retenir trois cas priorisés
Jours 16 à 30, mesure initiale
relever l'indicateur de référence sur une période complète et faire valider la mesure
Jours 31 à 60, construction encadrée
bâtir le flux sur un périmètre restreint, installer le point de vérification, tester en double circuit
Jours 61 à 90, décision
mesurer dans les mêmes conditions, comparer, puis généraliser, ajuster ou arrêter
| Phase | Période | Activité | Livrable | Critère de passage |
|---|---|---|---|---|
| 1 | Jours 1 à 15 | Inventaire et qualification des processus | Liste priorisée de trois cas | Les trois cas obtiennent un verdict favorable sur au moins trois critères |
| 2 | Jours 16 à 30 | Relevé des indicateurs et cadrage | Mesure de référence documentée | Indicateur unique, relevé sur deux semaines minimum, validé par le métier |
| 3 | Jours 31 à 60 | Construction et test restreint | Flux en fonctionnement encadré | Taux d'erreur observé inférieur au seuil fixé au départ |
| 4 | Jours 61 à 90 | Mesure et arbitrage | Comparaison avant-après documentée | Décision formalisée : généraliser, ajuster ou arrêter |
“Nous avions déjà deux automatisations en place, sans jamais avoir su dire ce qu'elles rapportaient. La seule chose qui a changé notre discussion en comité, c'est d'avoir relevé le temps de traitement pendant trois semaines avant de brancher quoi que ce soit.”
Trois points concentrent l'essentiel des difficultés d'une PME menant seule cette séquence : le choix du cas d'usage, la construction d'une mesure crédible, et le raccordement au système d'information existant. C'est précisément le périmètre sur lequel un accompagnement extérieur apporte un gain, et celui des missions de Centauri.
Conseil du coach
Prévoyez dès le départ le critère qui vous ferait arrêter. Un projet sans condition d'arrêt ne se termine jamais, il s'oublie.
Phase 1 et 2 : choisir le bon cas et mesurer avant
L'inventaire se conduit par entretien, service par service, avec une question unique : quelles tâches votre équipe répète-t-elle chaque semaine sans y ajouter de jugement ? Notez le volume estimé, le nombre de variantes et le nom de la personne qui connaît le mieux le processus. Une matinée par service suffit généralement à produire une liste exploitable de quinze à vingt candidats, que la grille d'éligibilité ramène à trois.
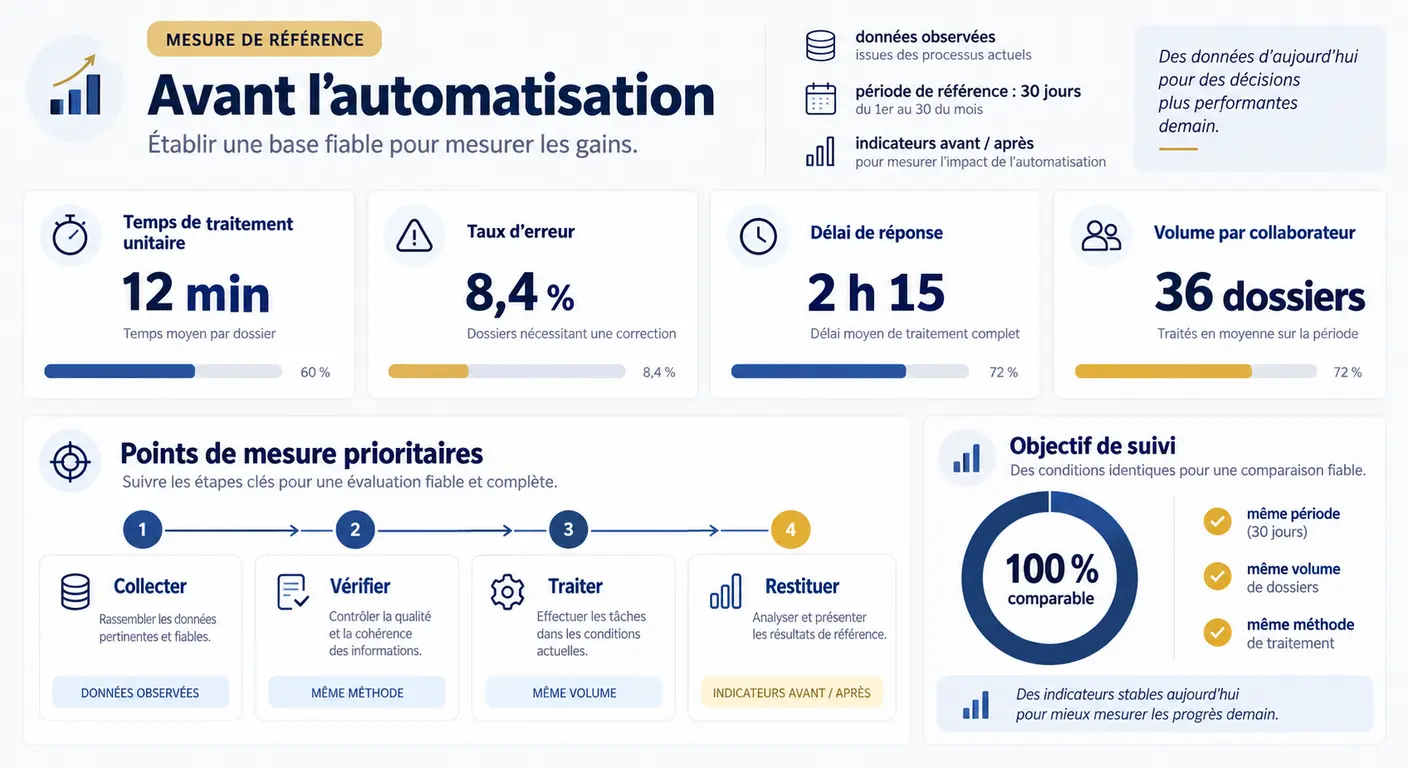
Le relevé de référence obéit à une règle : un seul indicateur par cas, choisi pour être incontestable. Pour un traitement de documents, retenez le temps de traitement unitaire. Pour un processus où la qualité prime, retenez le taux d'erreur constaté. Pour une activité de relation client, retenez le délai de première réponse. Pour une fonction de production, retenez le volume traité par personne et par jour. Relevez sur deux semaines pleines minimum, en incluant une période de charge normale, et faites valider le chiffre par le responsable concerné avant d'aller plus loin. C'est cette validation, plus que la mesure elle-même, qui rendra la comparaison finale indiscutable et alimentera votre tableau de bord de suivi.
Phase 3 : construire petit, contrôler serré
Le périmètre restreint est un choix délibéré, pas une contrainte subie. Un seul type de document, un seul canal d'entrée, une seule équipe utilisatrice. Cette restriction réduit le nombre de cas particuliers à traiter, accélère la construction, et rend les erreurs immédiatement identifiables. Élargir viendra ensuite, cas par cas, une fois la mécanique éprouvée.
Le fonctionnement en double circuit est l'autre exigence de cette phase. Pendant deux semaines, le traitement manuel continue en parallèle du flux automatisé, sur les mêmes éléments. Vous comparez les deux sorties, vous relevez les écarts, et vous obtenez ainsi le taux d'erreur réel, mesuré et non supposé. Ce fonctionnement coûte deux semaines de charge doublée sur un périmètre étroit, et c'est le seul moyen d'objectiver la fiabilité avant de retirer le filet. Les organisations qui sautent cette étape découvrent leur taux d'erreur par réclamation client, ce qui revient bien plus cher. C'est aussi pendant cette période que se construit l'adhésion des utilisateurs, qui voient le système se tromper, le corrigent, et finissent par lui faire confiance sur des bases vérifiées — un effet que la seule formation aux outils ne produit jamais aussi bien.
Conseil du coach
Faites tourner l'ancien et le nouveau processus en parallèle pendant deux semaines. C'est le seul moyen d'objectiver le taux d'erreur réel.
Phase 4 : mesurer, décider, et savoir quand se faire aider
La mesure finale reprend strictement le protocole initial : même indicateur, même période de référence, mêmes conditions. Deux ajouts sont indispensables pour que la comparaison soit honnête : le temps de vérification humaine résiduel et le temps de maintenance constaté sur la période. Un gain brut de plusieurs heures qui s'accompagne de deux heures de revue hebdomadaire n'est pas le même gain.
Trois décisions sont alors possibles, et toutes trois sont acceptables. Généraliser, en élargissant progressivement le périmètre. Ajuster, en modifiant le seuil de confiance, le périmètre ou la règle de repli, puis en remesurant. Arrêter, en documentant la raison, ce qui évitera de relancer le même chantier dans dix-huit mois. Ce qui ressort le plus nettement de ces séquences, c'est que l'outil n'est jamais le point difficile : le cadrage, la mesure et l'intégration au système d'information le sont. C'est précisément le périmètre d'un accompagnement extérieur comme celui de projetcentauri.com, dont chaque mission commence par un audit de faisabilité et se termine par des métriques avant-après documentées. Un audit préalable structuré permet d'éviter les trois cas les plus fréquents d'enlisement.
Ce qu'il faut retenir avant de lancer votre premier flux
Quatre décisions structurent l'ensemble de la démarche, et elles se prennent dans cet ordre. Qualifier la tâche avant de choisir l'outil, en appliquant les quatre critères de volume, de variabilité, de tolérance à l'erreur et de propriété métier. Budgéter le coût complet sur vingt-quatre mois, avec ses six postes, plutôt que l'abonnement mensuel affiché. Classer les données avant de brancher un modèle, et faire découler de ce classement la règle de traitement applicable. Mesurer avant, pour pouvoir démontrer après, faute de quoi votre gain restera une opinion.
Reste l'affirmation la plus défendable, et la plus utile à porter en comité de direction : l'IA no-code ne remplace pas une capacité technique. Elle déplace le point d'effort, du développement vers le cadrage. Le travail ne disparaît pas, il change de nature — et il devient accessible à vos équipes métier.