L'adoption de l'IA générative progresse vite dans les PME et les ETI, et elle franchit aujourd'hui un seuil qui change la nature de la question. Tant que les modèles servaient à reformuler des brouillons, l'endroit où tournait le calcul restait théorique. Dès qu'un modèle touche un dossier client, une pièce comptable, un contrat ou un dossier RH, cette question devient un point d'arbitrage en comité de direction.
La réponse par défaut du marché — « local égale sécurisé, cloud égale risqué » — est un raccourci coûteux. Il produit des budgets qui dérapent et des architectures surdimensionnées pour des besoins qui n'en demandaient pas tant. La réalité comporte quatre régimes de déploiement et non deux : l'API cloud propriétaire, l'inférence gérée sur modèle ouvert, le GPU dédié opéré en interne, et la machine isolée du réseau. Ces quatre régimes structurent l'ensemble de cet article.
Ce guide vous apporte trois choses : un arbre de décision à trois variables, un calcul de coût complet qui intègre les postes habituellement oubliés, et une distinction nette entre ce qu'un déploiement de LLM local en entreprise résout réellement et ce qu'il ne résout pas. Nous traitons ensuite la conformité, le RAG, le dimensionnement matériel et la réversibilité.
Ce que « LLM local » veut réellement dire : quatre régimes, pas deux
L'expression recouvre des situations tellement différentes qu'elle en devient trompeuse en réunion. Nommer précisément les quatre régimes est la première condition d'une décision défendable.
L'API cloud propriétaire. Le modèle et l'infrastructure appartiennent au fournisseur. Vos données quittent votre périmètre pour être traitées chez lui, sous les conditions de son contrat et de sa juridiction. Aucune compétence d'exploitation n'est requise de votre côté, la mise en œuvre se compte en jours, et la facturation suit l'usage au token. C'est le régime le plus rapide à activer et le moins maîtrisé sur le flux de données.
L'inférence gérée sur modèle ouvert. Un modèle open-weights est hébergé et opéré par un prestataire, facturé au token, sans serveur à votre charge. Vous choisissez le modèle, vous choisissez la juridiction de l'hébergeur, mais vous n'opérez rien. C'est le régime le plus mal identifié du marché — beaucoup de dirigeants ignorent qu'il existe — et c'est pourtant le plus souvent le bon compromis pour une entreprise qui veut sortir des API américaines sans monter une équipe d'infrastructure.
Le GPU dédié opéré en interne. L'entreprise loue ou achète la machine et opère elle-même le serveur d'inférence. C'est ici que se situe le véritable modèle de langage auto-hébergé en entreprise : contrôle maximal sur la configuration, sur les versions, sur la journalisation, mais exploitation intégralement à votre charge. La facturation porte sur le temps d'allumage, indépendamment du volume traité.
La machine isolée du réseau. Aucune connectivité entrante ni sortante, transferts par support physique chiffré, procédure d'administration spécifique. Ce régime de niche est réservé aux données dont la sortie du périmètre est juridiquement impossible — défense, certains dossiers d'instruction, certaines données de santé sous protocole. Il n'est pertinent que si la contrainte l'impose.
Le point de confusion opérationnel mérite d'être posé sans détour : beaucoup d'entreprises croient choisir le régime 3 alors que leur besoin correspond au régime 2. Elles budgètent une machine, recrutent ou mobilisent un profil d'exploitation, et découvrent l'écart au moment de la mise en production, quand le prototype mono-utilisateur doit devenir un service partagé. Un LLM souverain pour entreprise ne suppose pas nécessairement une machine dans vos murs : il suppose une juridiction maîtrisée et un contrat lisible.
| Critère | API cloud propriétaire | Inférence gérée | GPU dédié interne | Machine isolée |
|---|---|---|---|---|
| Maîtrise du flux de données | Faible | Contractuelle et juridictionnelle | Complète | Totale |
| Compétence interne requise | Aucune | Intégration uniquement | Exploitation continue | Exploitation et procédures |
| Structure de coût | À l'usage | À l'usage | Temps d'allumage | Investissement et exploitation |
| Réversibilité | Élevée | Élevée | Moyenne | Faible |
| Délai de mise en œuvre | Quelques jours | 1 à 3 semaines | 2 à 4 mois | 4 à 9 mois |
Comparatif des quatre régimes de déploiement d'un modèle de langage en entreprise
Les trois variables qui décident réellement
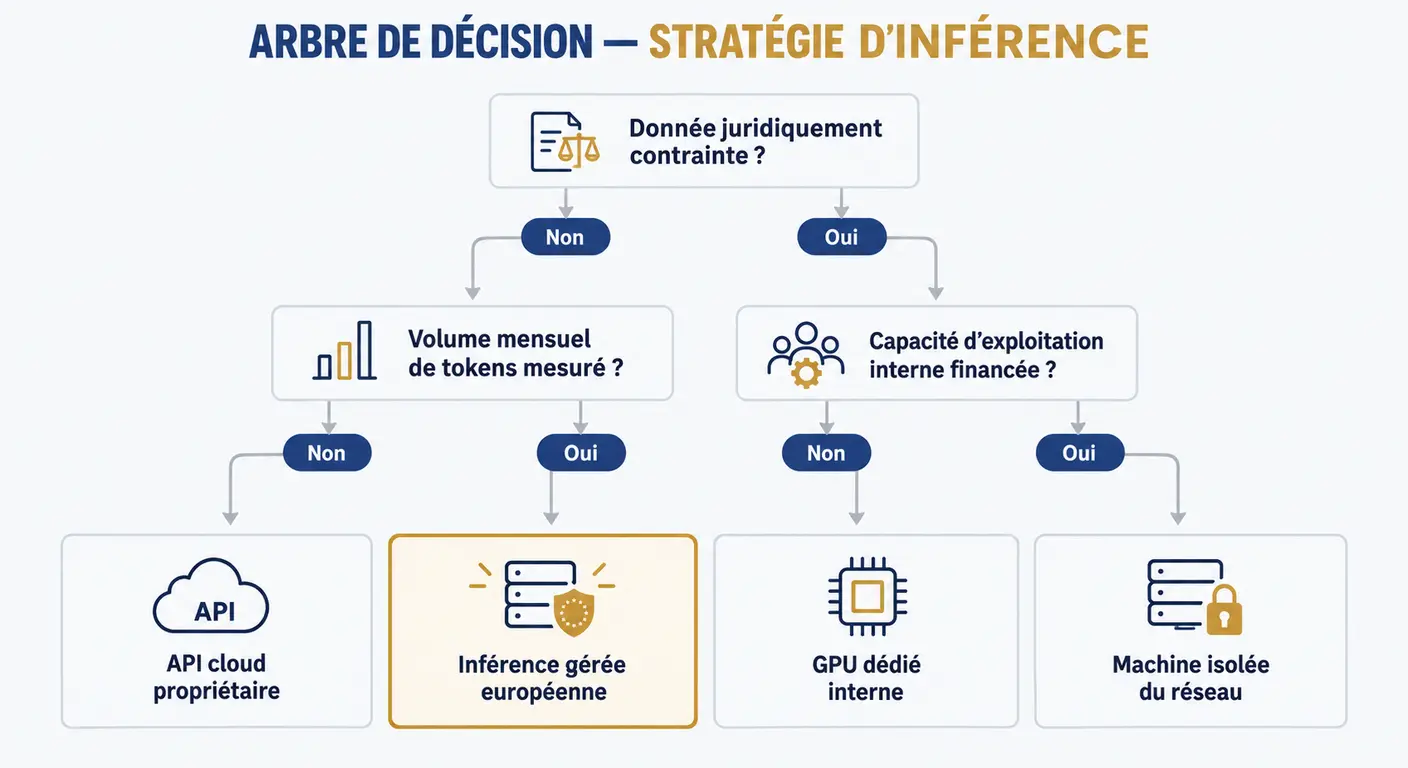
L'arbitrage ne se joue pas sur une préférence technologique mais sur trois variables mesurables. Elles se lisent dans l'ordre, et chacune peut clore le débat.
La sensibilité juridique de la donnée
Distinguez la donnée perçue comme sensible de la donnée juridiquement contrainte. Une note commerciale interne, une trame d'argumentaire ou un compte rendu de réunion sont confidentiels : leur fuite serait désagréable, elle n'est pas illégale. Un dossier de santé, un dossier RH nominatif, une pièce couverte par le secret professionnel de l'avocat ou de l'expert-comptable relèvent d'un régime différent, où le cadre d'exercice impose des conditions qui ne se négocient pas.
Cette distinction est la plus mal faite en pratique, parce que la crainte se porte sur le volume de données plutôt que sur leur qualification. La question à poser en interne est fermée : qui, aujourd'hui, a le droit de voir cette donnée, et ce droit change-t-il si elle est traitée par un sous-traitant hors Union européenne ?
Le volume mensuel de tokens
C'est la variable qui tranche l'économie, et elle est presque toujours inconnue au moment de la décision. Les entreprises arbitrent sur une intuition de volume, généralement calquée sur l'ambition affichée du projet plutôt que sur l'usage observé.
La méthode de mesure est simple et non négociable : instrumentez le prototype pendant quatre-vingt-dix jours, comptez les tokens entrants et sortants par cas d'usage, distinguez le contexte injecté du texte produit, puis extrapolez sur la trajectoire d'adoption réelle. Une adoption interne progresse rarement de façon linéaire ; elle plafonne souvent bien en dessous de la cible annoncée en cadrage. La question : combien de tokens mon cas d'usage consomme-t-il réellement, mesuré et non estimé ?
La capacité d'exploitation interne
Un serveur d'inférence en production n'est pas un projet, c'est un service à maintenir. Mise à jour de modèle, supervision de la charge, gestion de capacité aux heures de pointe, correctifs de sécurité, astreinte. Ces charges ne disparaissent pas parce que le déploiement est réussi ; elles commencent le jour où il l'est.
Beaucoup d'équipes découvrent ce poste après coup, en même temps que la première indisponibilité. La question : qui répond si le service tombe un vendredi soir, et ce rôle est-il financé, ou repose-t-il sur la bonne volonté d'une personne ?
Ces trois variables se lisent dans cet ordre. La première peut clore le débat à elle seule si la contrainte juridique est forte. La deuxième détermine l'économie. La troisième détermine la faisabilité réelle, indépendamment du budget.
Le calcul économique complet, postes cachés inclus
La plupart des comparaisons publiées opposent un prix au token à un prix de machine. Ce calcul est faux par construction, parce qu'il compare un coût complet à un coût partiel.
Le coût visible. L'API propriétaire et l'inférence gérée facturent à l'usage : vous payez ce que vous consommez, à la requête près. Le GPU dédié facture le temps d'allumage, qu'il traite dix requêtes ou dix millions. Une instance GPU de milieu de gamme louée en continu chez un hébergeur européen se situe, selon les tarifs publics relevés en septembre 2026, dans une fourchette de plusieurs centaines à quelques milliers d'euros par mois selon la carte et l'engagement. À usage faible, le coût par requête devient absurde ; à usage intense, il devient imbattable. Tout l'enjeu est de savoir de quel côté du seuil vous vous situez, et cela suppose d'avoir mesuré.
Les postes que personne ne compte. C'est ici que les budgets dérapent :
- L'ingénierie de mise en production. Passer d'un prototype mono-utilisateur — typiquement une installation locale à la Ollama — à un service multi-utilisateur avec gestion de file d'attente, mise en lot des requêtes, authentification et quotas, représente un saut technique réel. Comptez plusieurs semaines-personnes, pas quelques jours.
- La supervision et l'astreinte. En équivalent temps plein partiel, c'est le poste le plus systématiquement oublié, parce qu'il n'apparaît dans aucun devis d'infrastructure.
- La mise à jour de modèle. Le paysage open-weights se renouvelle en continu. Chaque bascule est un travail d'évaluation, de comparaison sur votre jeu de test et de non-régression sur les cas de production. Ce n'est pas un événement rare, c'est une charge récurrente.
- Le coût d'une interruption de service. Si l'IA générative est entrée dans un processus métier, son indisponibilité a un coût opérationnel qu'il faut chiffrer avant, pas après.
- L'obsolescence matérielle. Une carte achetée se déprécie sur un cycle court dans un marché où les architectures évoluent vite.
L'effet sur le point de bascule. Ces postes déplacent le seuil de rentabilité du local nettement vers le haut par rapport aux calculs habituellement publiés. Une entreprise qui migre uniquement pour réduire sa facture, sans avoir mesuré son volume réel, finit presque toujours par payer davantage qu'avant — en additionnant le coût de la machine et celui du temps qu'elle mobilise. La règle de lecture tient en une phrase : sous un volume que la majorité des PME n'atteignent pas, le local est un choix de contrôle, pas un choix d'économie. Si votre motivation principale est budgétaire, commencez par mesurer le ROI de votre usage actuel avant d'engager une infrastructure.
- Plusieurs centaines à quelques milliers d'eurosfourchette mensuelle d'une instance GPU dédiée allumée en continu, selon la carte et l'engagement, tarifs relevés en septembre 2026
- 50 à 70 %part du budget total d'un projet d'inférence interne représentée par l'exploitation et l'ingénierie, et non par l'infrastructure elle-même
- 90 joursdurée minimale d'instrumentation d'un prototype avant toute décision d'infrastructure, pour disposer d'un volume mesuré et non estimé
Tarifs publics d'hébergeurs GPU européens relevés en septembre 2026 ; ordres de grandeur issus de missions de cadrage Centauri
Ce qu'un LLM local résout, et ce qu'il ne résout pas
Cette section est la plus utile en comité, parce qu'elle désamorce les deux erreurs symétriques : sous-estimer le bénéfice réel du local, et lui prêter des vertus qu'il n'a pas.
Ce qu'il résout. L'exfiltration, d'abord : la donnée ne quitte pas le périmètre que vous maîtrisez, et cette maîtrise est démontrable auprès d'un auditeur, d'un client ou d'une autorité. La dépendance à la disponibilité et aux conditions commerciales d'un tiers, ensuite : un changement de tarif, de politique d'usage ou de dépréciation de modèle ne vous est plus imposé. La soumission à des législations extraterritoriales de type Cloud Act, lorsque le prestataire relève d'une juridiction non européenne, est également écartée — c'est l'argument central d'une IA générative on-premise pour données confidentielles. Enfin, l'affinage sur données métier devient possible, puisqu'il suppose un accès complet aux poids du modèle.
Ce qu'il ne résout pas. C'est le point le plus important de cet article. Un déploiement local :
- ne protège pas de l'injection d'invites, qui vise le modèle et le contenu qu'il traite, pas le réseau — un document piégé reste piégé sur votre propre serveur ;
- ne corrige pas les sorties erronées énoncées avec assurance, ni l'excès de confiance des utilisateurs face à une réponse bien formulée ;
- n'empêche pas le recours non autorisé à des outils d'IA publics par vos collaborateurs, qui reste un problème de politique interne, de sensibilisation et de contrôle des postes de travail — un serveur interne parfaitement sécurisé ne dit rien de ce qui est collé dans un navigateur ;
- ne dispense d'aucune obligation issue du règlement général sur la protection des données : base légale du traitement, information des personnes concernées, durée de conservation, gestion des droits d'accès et d'effacement, sécurité, traçabilité, analyse d'impact quand le traitement le justifie ;
- ne sécurise rien s'il est mal configuré. Un serveur d'inférence accessible sans authentification dans un réseau plat, avec des journaux conservés indéfiniment sur un volume non chiffré, déplace le risque à l'intérieur de vos murs — il ne le supprime pas.
La formule qui structure cette section mérite d'être reprise telle quelle en réunion : le local change le périmètre du risque, il ne change pas la nature du risque. Elle vous évitera de confondre un choix d'architecture avec une politique de sécurité, laquelle relève d'un travail distinct sur la protection des données dans vos usages IA.
Ce qu'un LLM local ne vous dispense pas de faire
Documenter la base légale
le fondement juridique du traitement reste à établir, quel que soit le lieu d'exécution du modèle
Définir la conservation des journaux
les traces d'inférence contiennent des données ; leur durée de conservation doit être fixée et justifiée
Protéger contre l'injection d'invites
le filtrage des contenus non fiables et le cloisonnement des actions du modèle restent nécessaires
Encadrer les usages d'outils publics
une politique interne et un contrôle des postes restent le seul rempart contre l'IA fantôme
Authentifier et cloisonner le service
un serveur d'inférence ouvert dans un réseau plat est une vulnérabilité, pas une protection
Vérifier les sorties à enjeu
aucune architecture ne corrige une réponse fausse énoncée avec assurance
Conformité : ce que dit le cadre européen, sans raccourci
Le sujet est fréquemment traité de travers, avec des formulations qui ne résistent pas à une lecture juridique. Reprenons dans l'ordre.
Responsable de traitement et sous-traitant. Le recours à un prestataire est encadré, pas interdit. Le règlement organise cette relation par un contrat de sous-traitance, des garanties documentées et un encadrement des transferts hors Union européenne. Écrire que le RGPD « interdit le cloud » est faux et vous fera perdre en crédibilité devant un délégué à la protection des données. En revanche, vous restez responsable de traitement quel que soit le lieu d'exécution : un déploiement interne ne transfère aucune responsabilité, il en concentre certaines.
Sécurité appropriée au risque. L'obligation porte sur l'adéquation des mesures au risque, pas sur une architecture particulière. Un déploiement local facilite la démonstration de certaines mesures — le flux ne sort pas — mais ne les satisfait pas automatiquement. Un serveur interne mal administré expose davantage qu'une inférence gérée correctement contractualisée.
Analyse d'impact. Son caractère obligatoire dépend du niveau de risque du traitement pour les personnes concernées, pas du lieu d'exécution. Un traitement de données RH à fort enjeu reste soumis à analyse d'impact qu'il tourne sur votre serveur ou sur une interface de programmation distante.
Traçabilité et journalisation. À concevoir dès l'architecture, pas à rattraper. Qui a interrogé quoi, quand, avec quel contexte injecté. Et surtout : la durée de conservation de ces journaux d'inférence doit être définie et justifiée, pas fixée par défaut sur la valeur de l'outil.
Le cadre européen sur l'intelligence artificielle ajoute une couche supplémentaire, et le principe y est identique : la classification d'un système dépend du cas d'usage et de son impact sur les personnes, pas de l'hébergement. Un usage à fort enjeu — évaluation de candidatures, scoring, décision affectant une personne — reste à fort enjeu qu'il tourne sur un serveur interne ou sur une interface distante.
Un point que le marché traite mal mérite d'être souligné : les modèles open-weights n'ont pas de fournisseur à qui faire signer un contrat de sous-traitance. Vous téléchargez des poids, vous les exécutez, il n'y a personne en face. Cette absence de contrepartie contractuelle ne constitue pas une absence d'obligation ; elle déplace la charge de la preuve sur vous. Il vous revient de documenter en interne l'analyse de risque, les mesures techniques retenues, la politique de conservation et les conditions de licence du modèle utilisé, qui ne sont pas toutes équivalentes. Ces éléments s'inscrivent dans le cadre plus large d'une gouvernance de l'IA alignée sur le RGPD.
Rappel sectoriel pour finir : pour un cabinet comptable, un service RH ou un établissement de santé, la contrainte peut être suffisamment forte pour que le prix cesse d'être un critère de décision. Le budget se construit alors autour de la contrainte, et l'arbitrage économique devient une simple optimisation à l'intérieur d'un périmètre imposé.
« Local donc conforme » : une équivalence qui n'existe pas
Un déploiement interne facilite la maîtrise du flux de données, mais il ne produit aucune conformité par lui-même : la base légale, l'information des personnes, la durée de conservation et la sécurité des accès restent intégralement à démontrer. Un serveur d'inférence mal administré dans vos murs vous expose davantage qu'une inférence gérée correctement contractualisée chez un hébergeur européen.
Le RAG local : là où se déplace vraiment la donnée sensible
La plupart des projets d'entreprise ne consistent pas à utiliser un modèle brut, mais à l'adosser à une documentation interne. Cette architecture, dite de génération augmentée par récupération, change complètement la localisation du risque — et cette conséquence est rarement anticipée.
Le principe, en langage clair : le modèle ne « connaît » pas vos documents internes. Il les reçoit au moment de la requête, extraits d'un index constitué en amont à partir de vos sources. La conséquence est structurante : la donnée sensible n'est plus seulement dans le prompt, elle est dans l'index et dans les droits qui le gouvernent.
Trois implications opérationnelles en découlent.
D'abord, l'index vectoriel doit respecter exactement les mêmes droits d'accès que les documents sources. Sans cette précaution, une IA interne devient un contournement de la gestion des habilitations : un collaborateur obtient par la synthèse ce qu'il ne pourrait pas ouvrir directement. Il ne verra jamais le fichier, mais il en lira le contenu reformulé. C'est un incident de sécurité complet, produit par une architecture qui semblait pourtant confinée.
Ensuite, la qualité des sources prime sur la puissance du modèle. Un corpus interne non nettoyé — versions obsolètes, doublons contradictoires, procédures périmées jamais retirées — produit des réponses fausses quel que soit le modèle utilisé. Aucune montée en gamme sur les paramètres ne compense un référentiel documentaire en désordre.
Enfin, le régime de déploiement du modèle et celui de l'index peuvent différer, et c'est souvent la bonne réponse. Un index hébergé sur votre infrastructure maîtrisée peut alimenter un modèle en inférence gérée, ou l'inverse, selon la sensibilité réelle des documents. Cette dissociation est un levier d'arbitrage sous-exploité, qui permet de concentrer l'effort de maîtrise là où la donnée le justifie vraiment.
C'est donc généralement le RAG, et non le modèle, qui justifie ou non un déploiement local.
L'index vectoriel, angle mort des habilitations
Lorsqu'un index est constitué à partir d'un partage de fichiers sans reprendre les droits d'accès associés, toute personne interrogeant l'assistant peut obtenir, sous forme de synthèse, le contenu de documents qu'elle n'a pas le droit d'ouvrir. Le contrôle d'accès doit être appliqué au moment de la récupération, par filtrage sur l'identité de l'utilisateur, et non seulement à l'entrée de l'interface.
Dimensionner le matériel et garder la portabilité
Les trois leviers de dimensionnement
La taille du modèle. Quelques milliards de paramètres suffisent largement pour le résumé, la classification, l'extraction structurée et la reformulation — c'est-à-dire pour la majorité des usages d'entreprise réellement déployés. Plusieurs dizaines de milliards deviennent nécessaires pour le raisonnement à étapes multiples, l'analyse de documents longs et la génération de code complexe. Cadrez votre usage avant de dimensionner : surdimensionner par précaution est l'erreur budgétaire la plus courante, et elle coûte tous les mois.
La quantification. Réduire la précision des poids permet de faire tenir un modèle plus grand sur une carte plus petite, au prix d'une perte de qualité souvent imperceptible sur des tâches cadrées, et plus sensible sur le raisonnement. C'est le levier qui déplace le plus fortement le coût matériel à performance utile constante. Il se teste sur votre jeu d'évaluation, pas sur des classements publics.
Location ou achat. Louer convient à un pilote, à une charge variable et à une trajectoire incertaine — c'est-à-dire à la quasi-totalité des projets au départ. Acheter ne se justifie qu'avec une charge stable, prévisible et durable sur plusieurs années, et suppose d'assumer l'obsolescence matérielle ainsi que l'immobilisation comptable qui l'accompagne.
Ne pas s'enfermer
Le risque principal d'une IA sans cloud pour données sensibles n'est pas le coût, c'est l'irréversibilité. Une architecture construite autour d'un moteur d'inférence particulier, avec des appels codés en dur, devient très coûteuse à faire évoluer dès qu'elle est en production.
Posez la parade dès le premier prototype : faites transiter tous les appels par une interface standardisée, de sorte que changer de modèle ou de régime de déploiement devienne un changement de configuration et non un chantier de réécriture. Cette couche de portabilité permet également de faire cohabiter plusieurs régimes — un modèle auto-hébergé pour le flux courant, un modèle géré en secours ou pour les cas complexes, avec bascule automatique. C'est aussi ce qui rend possible une intégration progressive dans votre système d'information sans engagement irréversible.
Le coût de mise en place de cette couche est quasi nul au départ, parce qu'elle ne fait qu'organiser des appels que vous écrirez de toute façon. Le coût de rattrapage, une fois le service en production et intégré à plusieurs processus métier, est élevé. C'est l'une des rares décisions d'architecture où le bon moment est le premier jour.
Du prototype à la production, dans l'ordre
Valider le modèle sur les cas réels
constituer un jeu d'évaluation issu de votre production et comparer deux ou trois candidats dessus
Mesurer le volume sur 90 jours
instrumenter le prototype et compter les tokens entrants et sortants par cas d'usage
Choisir le régime
croiser la contrainte juridique, le volume mesuré et la capacité d'exploitation financée
Poser la couche de portabilité
centraliser les appels derrière une interface standardisée avant la mise en production
Industrialiser l'exploitation
supervision, quotas, procédure de mise à jour de modèle et rôle d'astreinte identifié
Instruire la décision avec ses propres chiffres
Cet article vous a fourni une grille. Elle a une limite structurelle : elle ne se remplit qu'avec vos données internes. Le volume réellement mesuré, la cartographie des données effectivement contraintes sur le plan juridique, la capacité d'exploitation disponible et financée — ces trois entrées sont propres à votre organisation, et aucune publication ne peut les fournir à votre place.
C'est précisément cette instruction qui manque dans la plupart des entreprises. Non par négligence, mais faute de temps et de référent disponible pour porter le sujet entre la direction des systèmes d'information, la direction juridique et les métiers concernés. Le projet reste alors suspendu entre une intuition de risque et une intuition de coût, sans qu'aucune des deux ne soit vérifiée.
Chez Centauri, la démarche se déroule en cinq temps factuels : qualification du cas d'usage avec les équipes concernées, mesure de la consommation réelle sur un prototype instrumenté, cartographie juridique des données effectivement traitées, arbitrage documenté entre les quatre régimes, puis métriques avant et après consignées. Un audit de faisabilité précède systématiquement tout engagement d'infrastructure — c'est la traduction opérationnelle du principe qui traverse cet article : mesurer avant d'acheter.
Ce qu'il faut retenir avant de s'engager
Si aucune donnée n'est juridiquement contrainte et que le volume reste modéré, l'API cloud ou l'inférence gérée demeure le choix le plus rationnel. Un déploiement interne serait un surcoût sans contrepartie : vous paieriez une machine et un temps d'exploitation pour obtenir un service que vous aviez déjà, avec une réversibilité moindre.
Si une contrainte réglementaire stricte impose que la donnée ne sorte pas d'un périmètre défini, le débat économique est clos avant d'avoir commencé. Le budget se construit alors autour de la contrainte, et la discussion se déplace vers le dimensionnement juste et la maîtrise du coût d'exploitation.
Entre les deux — c'est-à-dire dans la grande majorité des cas —, l'inférence gérée sur modèle ouvert chez un hébergeur européen constitue la porte d'entrée la plus raisonnable. Elle laisse le temps de mesurer le volume réel sans recruter une équipe d'exploitation, tout en écartant la dépendance à une juridiction extraterritoriale. Elle n'interdit rien pour la suite.
Quel que soit le chemin retenu, la réversibilité se pose au premier jour et ne coûte presque rien à ce moment-là. Elle se rattrape en production, et coûte alors cher en temps, en risque et en interruption de service.
Le principe directeur, pour finir : le choix du lieu d'exécution d'un modèle est une décision de gouvernance de la donnée avant d'être une décision d'infrastructure. Instruite dans cet ordre, elle se défend en comité. Instruite dans l'autre, elle se subit.
“Le lieu d'exécution d'un modèle ne définit pas votre niveau de risque. Il définit le périmètre à l'intérieur duquel vous devrez, de toute façon, démontrer que vous le maîtrisez.”